作者|瞻新資訊 張安邦執行長(台大醫工背景・十年以上IT服務公司創辦人)
如果你收過一份弱點掃描報告,大概看過那個畫面:幾十行紅字,每一行後面跟著一個分數,最高的那幾個是 9.8。
然後呢?全部修完要很久,預算也不一定夠。問廠商,廠商回你「建議都修」——問完等於沒問。
這篇要處理的就是這個問題:當你不可能全部都修,該先修哪一個? 順便回答另外兩個很少人講清楚的:客製化的系統為什麼掃不出東西,以及用 AI 寫的程式碼到底多了什麼風險。
這篇不是寫給工程師看的,是寫給要做決定、但自己不寫程式的人看的。
先分清楚,設定沒關好跟程式本身有洞是兩件事
開始之前先把兩件常被混在一起的事分開,因為它們的處理方式完全不同。
一種是設定問題:預設密碼沒改、用不到的功能還開著、權限給太寬。這一類不用改程式,改設定就好,通常也不花錢。
另一種是程式漏洞:程式碼本身寫的時候就留下了可以被利用的破綻。這一類非得有人動原始碼不可,要嘛等原廠釋出更新,要嘛請工程師改。
前者站上另一篇〈網頁安全的攻擊面盤點:權限、設定、第三方套件,中小企業先顧這三個〉整理得比較完整,而且那篇裡面有六項是你自己就管得到的。這篇專門處理後者。
💡 小提醒
如果你還沒讀過那篇,建議先看。因為設定那一類的 CP 值高很多——不用寫程式、不用花錢、影響範圍卻很大。程式漏洞這一類必然要動用工程資源,所以更需要排優先順序。
一句話收尾:能靠改設定解決的先解決,剩下的才是這篇要排順序的東西。
漏洞有身分證,但身分證上沒寫「急不急」
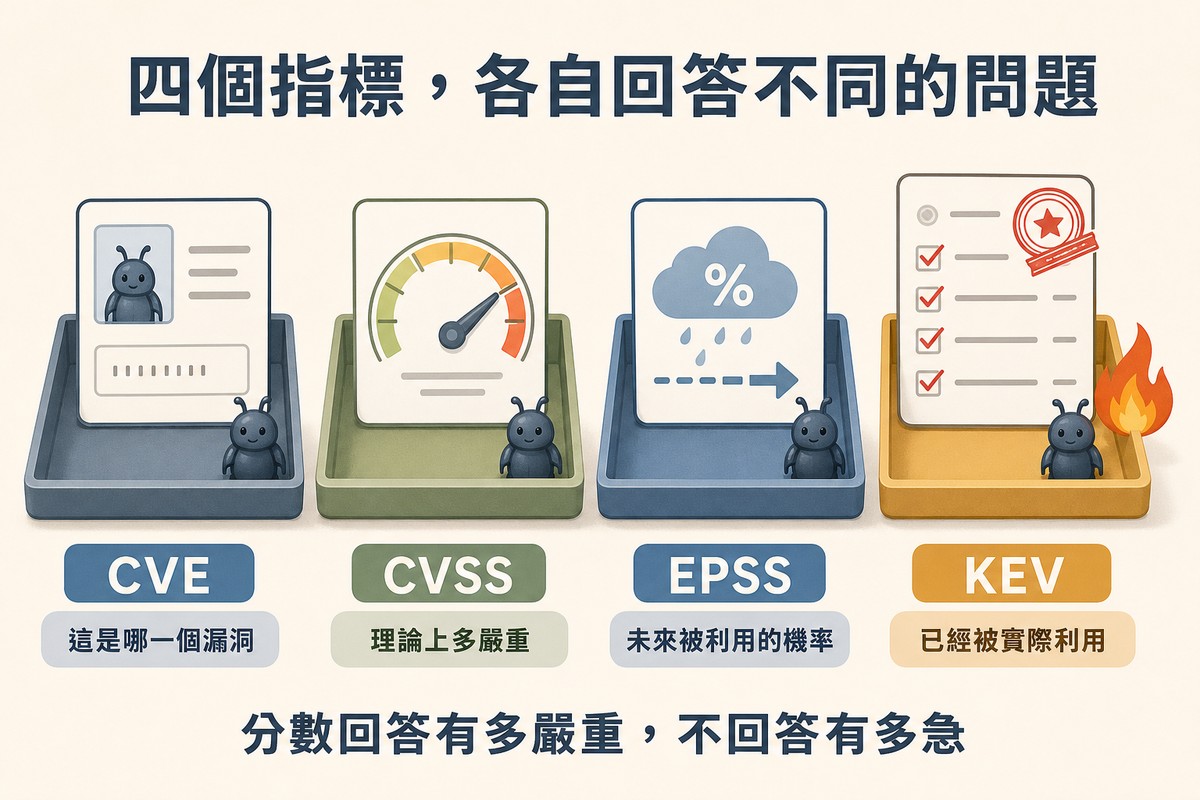
當一個軟體被發現有漏洞,國際上會給它一個編號,叫 CVE。
你可以把 CVE 想成漏洞的身分證字號:它唯一、不重複,全世界的人講到同一個漏洞時,可以確定在講同一件事。但身分證字號只是編號,它本身不告訴你這個人危不危險。
所以另外有一套評分叫 CVSS,從 0 分到 10 分,分數越高代表理論上越嚴重。這就是你在掃描報告上看到的那些數字。
問題來了:CVSS 分數是「理論上多嚴重」,不是「對你多急」。
它評估的是這個漏洞被成功利用之後,破壞力有多大、利用難度有多高。但它不回答這幾個問題:
- 我的系統真的有用到那個元件、那個版本、那個功能嗎?
- 那個元件有沒有暴露在網際網路上,還是只在內網跑?
- 現在外面有沒有人真的在用這個漏洞攻擊?
最後那一題最關鍵。理論上很嚴重、但實際上沒人在用的漏洞,跟理論上中等、但全世界正在被大量利用的漏洞,哪一個該先修?
一句話收尾:分數回答的是「有多嚴重」,不是「有多急」,這兩件事經常不一樣。
真正決定先修哪一個的,是有沒有人正在用它打
近幾年資安圈的判斷方式有一個明顯轉向:不要只看分數。
多了兩個更貼近現實的指標:
KEV(已知遭利用漏洞清單)。美國的網路安全暨基礎設施安全局(CISA)維護一份清單,收錄已經被確認在真實世界中被利用的漏洞,並要求聯邦機構限期修補。它的意義很直接:在這份清單上,代表已經有實際災情,不是理論推演。
這份清單的規模與嚴格程度值得一提。查閱當日(2026 年 9 月),KEV 收錄約 1,700 個漏洞——相較於每年新增的數萬個 CVE,這是一個經過篩選的、很小的集合。CISA 並以正式指令(BOD 26-04)要求聯邦機構依風險優先處理,許多近期列入的項目要求在 3 到 14 天內完成修補。
換句話說:一個漏洞能進 KEV,代表它已經通過了「有沒有真的在被利用」這個門檻;而美國聯邦政府對它的處理期限是以「天」計算的,不是以「下次維護時再說」計算的。這個對比本身就是排序依據。
EPSS(漏洞利用預測評分)。由國際資安事件應變組織 FIRST 維護,預測一個漏洞在未來一段時間內被利用的機率。它是預測,不是事實,但對排順序很有用。
四個名詞放在一起比較會清楚很多:
| 指標 | 誰維護 | 回答什麼問題 | 它不回答什麼 |
|---|---|---|---|
| CVE | MITRE | 這是哪一個漏洞 | 嚴不嚴重 |
| CVSS | FIRST | 理論上多嚴重(0–10 分) | 有沒有人在用、你有沒有暴露 |
| EPSS | FIRST | 未來被利用的機率 | 是預測,不是已發生的事實 |
| KEV | 美國 CISA | 已經被實際利用的清單 | 沒在清單上不等於安全 |
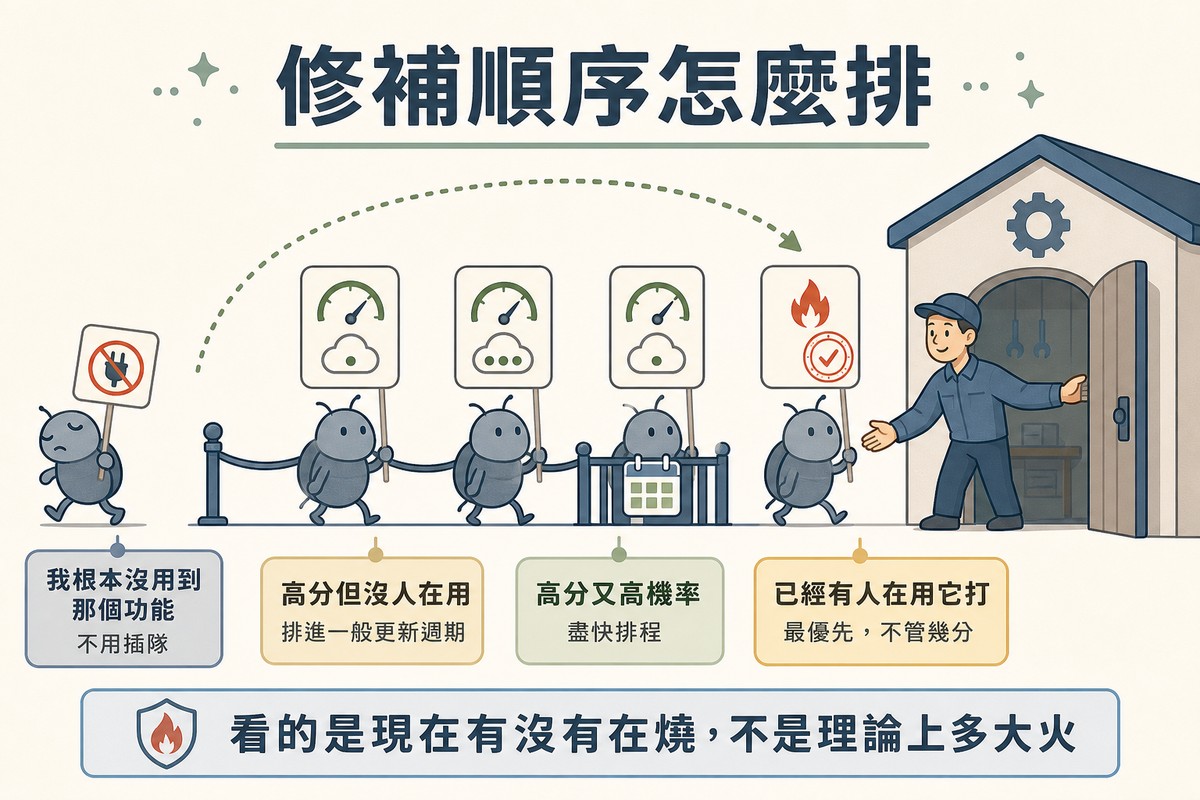
有了這四個,優先順序就排得出來了:
- 在 KEV 清單上的 → 最優先,不管幾分。 已經有人在用它打了,理論分數不重要。
- 不在 KEV,但高分 + 高 EPSS → 盡快排程。 破壞力強,而且很可能即將被利用。
- 高分但 EPSS 低、資產又沒對外暴露 → 排進一般更新週期。 不是不修,是不用插隊。
- 確認自己有沒有真的用到。 這一步常被跳過:報告列出來的元件,你的系統不一定真的在用那個功能。
第 4 點值得展開一下。假設報告列出一個 9.8 分的漏洞,出現在某個影像處理套件的特定功能上——但你的網站只用這個套件做縮圖,完全沒碰到那個功能。這種情況下它的實際風險遠低於 9.8。當然還是該更新,只是它不必插隊到今天晚上。
⚠️ 注意
這不是叫你忽略高分漏洞,而是在資源有限的情況下決定順序。如果你的預算與人力足以全部修完,那就全部修完,這一節的判斷方法是給「修不完」的情況用的——而那是中小企業的常態。
一句話收尾:排序看的是「現在有沒有在燒」,不是「理論上多大火」。
你的客製系統沒有編號,掃描掃不出來
這一節是中小企業最大的盲點,而且幾乎沒有人事先講。
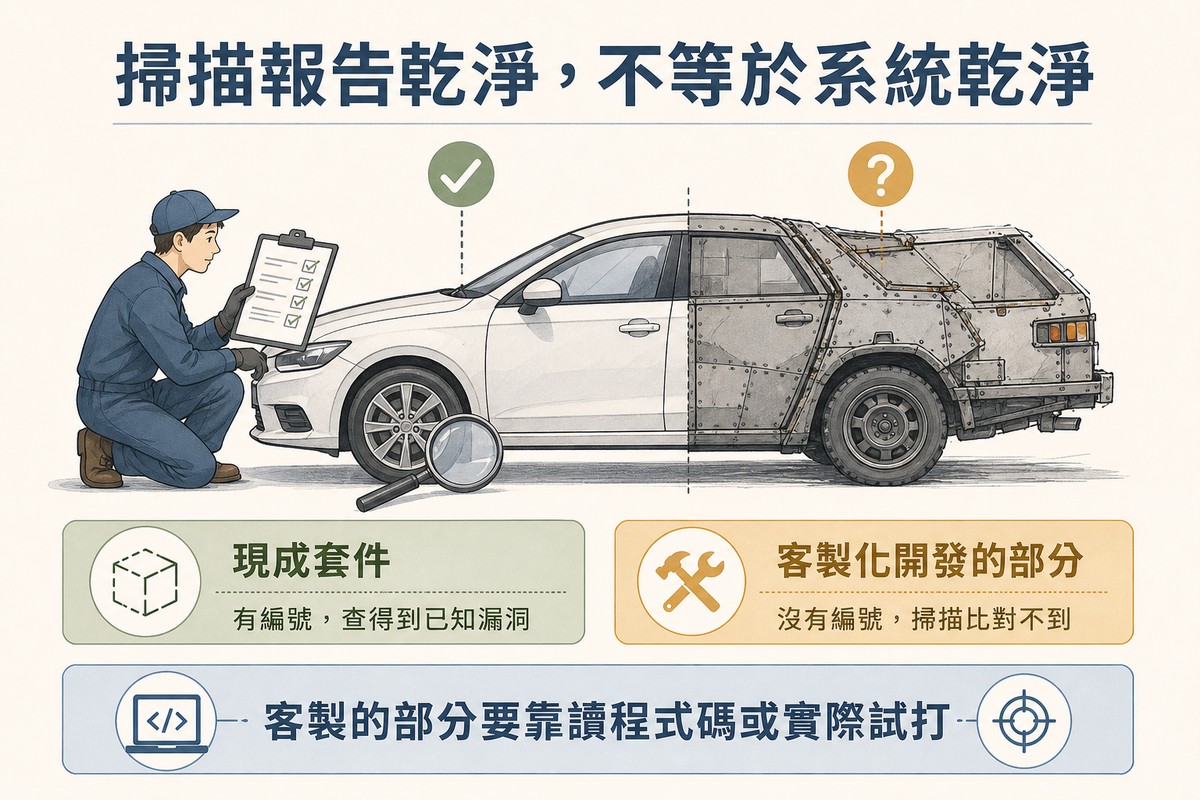
弱點掃描的原理,是拿你的系統去比對一份「已知漏洞資料庫」。它會看你用的是哪個版本的哪個套件,然後查那個版本有沒有已知的問題。
所以推論很直接:你家工程師寫的那段客製程式碼,不在任何資料庫裡,掃描掃不出來。
這件事的影響比想像中大。很多公司做完弱點掃描、拿到一份「無重大風險」的報告,就以為系統是安全的。但如果你的系統有大量客製化的部分——會員系統、訂單流程、後台權限判斷——那份報告其實沒有檢查到最關鍵的地方。
用比喻來說:這像是拿一份「已知瑕疵車款召回清單」去查你的車。清單上沒有你的車,只代表原廠沒有發布召回,不代表你那台改裝過的部分沒問題。
要檢查客製的部分,得用別的方式:
| 方式 | 在做什麼 | 適合什麼情況 | 大致成本結構 |
|---|---|---|---|
| 弱點掃描 | 自動比對已知漏洞資料庫 | 以現成系統與套件為主的網站 | 工具訂閱制,最便宜 |
| 原始碼審查 | 人工或工具實際讀程式碼 | 客製化開發的系統 | 按程式規模計價 |
| 滲透測試 | 模擬攻擊實際試打 | 上線前、重大改版後、有合規要求時 | 按次計價,最貴 |
💡 小提醒
如果你的網站是 WordPress 之類的現成系統加上一些外掛,弱點掃描的覆蓋率其實相當不錯,因為你用的東西都在資料庫裡。但只要有客製化的模組,就要意識到那一塊是掃描看不到的死角。
不過在買任何工具之前,有一件事的效益通常更高:把「套件更新」變成有人負責的例行工作。掃描報告上的多數項目,解法本來就是「更新到最新版」。如果更新這件事本來就有人定期在做,報告上的紅字會少掉一大半——而這件事不用花錢,只需要有人被指定。
「把更新變成例行工作」實際上是什麼意思
這句話講起來很虛,拆開來其實只有四個動作,而且都不需要技術背景:
- 列一份清單:系統核心、外掛、佈景主題、伺服器端的主要套件,各是什麼版本。沒有清單就沒有後面三步。
- 指定一個人,以及一個固定的時間(例如每月第一週)。不指定人的話,這件事永遠是「大家都覺得別人在做」。
- 訂閱安全公告。你用的系統與主要套件多半有官方公告管道;重大漏洞爆發時,這決定你是當天知道還是三個月後知道。
- 更新前先備份、更新後實際點一遍。這一步是給「怕更新會弄壞東西」的人的答案——顧慮是合理的,但正確的處理是先備份再更新,不是不更新。
第 4 點要特別講一下,因為「不敢更新」是實務上最常見的卡點。不更新的風險是累積的:拖越久,版本差距越大,將來真的非更新不可時(例如爆出重大漏洞),一次跨好幾個大版本,弄壞東西的機率反而更高。小步前進比大步跳躍安全。
一句話收尾:掃描報告乾淨,不等於系統乾淨,它只代表「已知的那些」你沒中。
AI 寫的程式碼,多了一個不太一樣的問題
這兩年多了一個新變數:越來越多程式碼是 AI 輔助生成的,包括一些原本不會寫程式的人,直接用 AI 做出了可以跑的系統。
學術界對這件事的研究相當多,結論也相當一致。發表在 ACM 軟體工程期刊上的一份實證研究分析了 GitHub 上使用 AI 助手生成的程式碼,確認其中存在一定比例的安全弱點;美國喬治城大學的 CSET 也發布過一份綜述報告整理這類風險。
但真正值得注意的不是「漏洞比例」這個數字——模型一直在更新,今年的數字明年就不準了。真正值得注意的是研究裡的另一個發現。
一份系統性文獻回顧指出:使用 AI 助手的開發者,不只寫出了明顯較不安全的程式碼,還表現出一種「虛假的安全感」——他們傾向把自己不安全的解法評為安全。
這個發現的意義,比漏洞比例大得多。
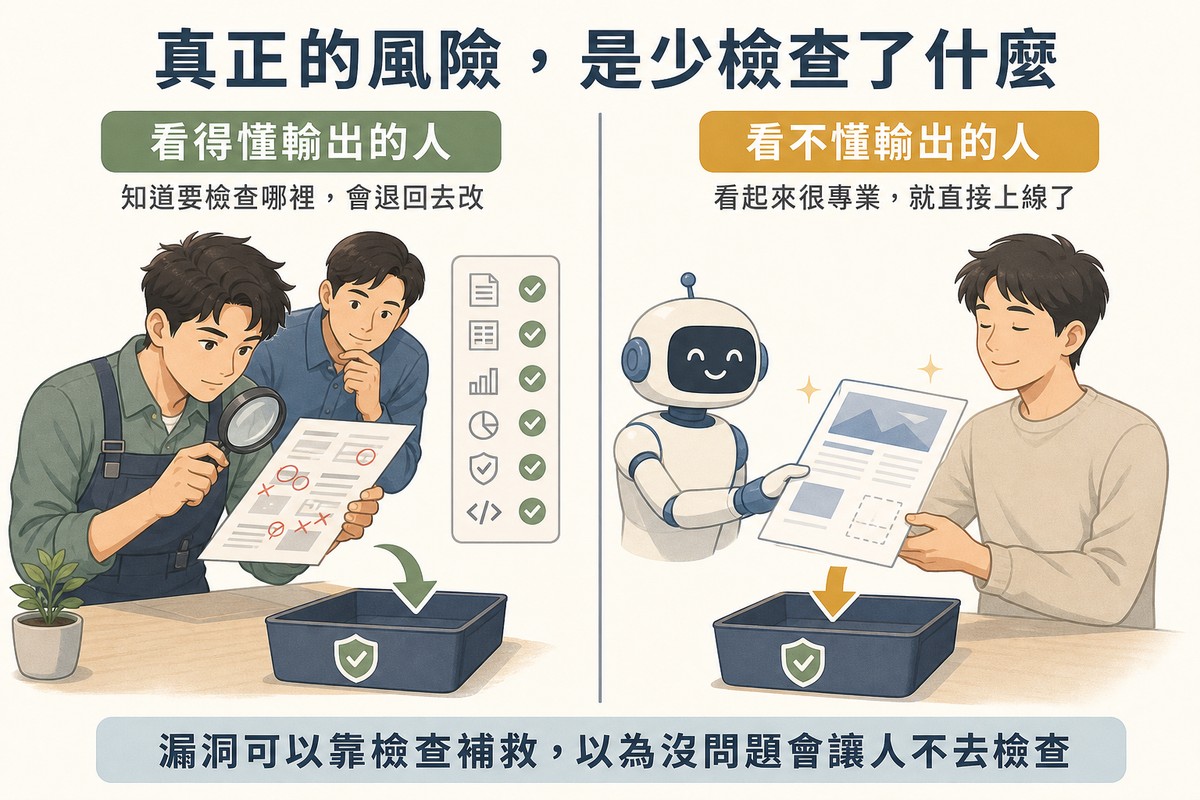
因為漏洞比例可以靠檢查來補救,但「以為沒問題」會讓人根本不去檢查。同樣一段有問題的程式碼,工程師寫的通常會經過 review、測試、同儕討論;AI 生成而且「看起來很專業」的那一段,常常直接就上線了。
⚠️ 注意
這不是在說 AI 不能用來寫程式。專業工程師用 AI 加速,跟不懂程式的人用 AI 生出一整套系統,是完全不同的兩件事——差別在於前者看得懂輸出、知道要檢查什麼。
風險落在後者:系統跑得起來、畫面看起來也對,但沒有人有能力判斷那些看不見的部分(權限判斷、輸入驗證、錯誤處理)寫對了沒有。
站上另一篇〈為什麼找專業工程師開發系統,比自己用AI做更重要?〉是從開發能力與專案結果的角度談這件事;這一節補的是安全性這個面向的實證資料。
一句話收尾:AI 的風險不只在它寫出什麼,更在它讓人少檢查了什麼。
不懂程式,也問得出來的四件事
最後回到實務。你不需要看得懂程式碼,也能判斷一個外包專案在漏洞管理上做得怎麼樣。問這四題就夠了:
① 這套系統用到哪些第三方套件?版本各是多少? 答不出來,代表沒有人在管更新——而更新是多數漏洞的解法。合理的回答是一份清單,不是「就一些常見的」。
② 上線之後,套件更新由誰負責、多久做一次? 這一題決定了半年後的狀況。維護合約裡有沒有寫,寫的是「有問題時處理」還是「定期更新」,差別很大。
③ 客製化的部分有沒有經過程式碼審查?誰審的? 呼應前面講的死角。合理的回答可以是「有另一位工程師 review」或「跑過靜態分析工具」,重點是有一個人或一個工具實際看過。
④ 如果將來爆出重大漏洞,通知管道是什麼? 有沒有人在訂閱所用套件的安全公告?還是等出事了才知道?
💡 小提醒
這四題寫進交付清單對雙方都好。廠商知道要交什麼、業主知道該收到什麼,不會事後才為了「這算不算在報價範圍內」爭執。而且這四題的答案,也正好是將來換廠商時最需要的交接資料。
回到最開始那份滿是紅字的掃描報告。真正該問的不是「這幾個要不要修」,是「這裡面哪幾個現在有人正在用」,以及「這份報告有沒有看到我們自己寫的那部分」。這兩個問題問出來,後面的決定會清楚很多。
如果你正在規劃新系統,想把套件管理、更新責任與程式碼審查這些條件直接寫進開發規格,而不是等上線之後才補,瞻新資訊的團隊可以協助把需求與驗收條件整理清楚。
FAQ
怎麼知道我的網站有沒有程式漏洞?
看你的網站是什麼組成。如果是 WordPress 之類的現成系統加外掛,弱點掃描的覆蓋率相當不錯,因為那些套件的已知漏洞都在資料庫裡;但只要有客製化開發的模組,那一塊掃描看不到,要靠原始碼審查或滲透測試。最低成本的第一步其實是確認「系統核心與套件是不是都在最新版」,多數已知漏洞的解法本來就是更新。
掃描報告上看到 9.8 分,是不是要馬上修?
不一定。CVSS 分數回答的是「理論上多嚴重」,不是「對你多急」。要先確認三件事:這個漏洞在不在 CISA 的 KEV 清單上(在就最優先,代表已經有人實際利用)、你的系統有沒有真的用到那個元件的那個功能、那個元件有沒有暴露在網際網路上。三者都成立才需要插隊處理;若只是分數高但沒人在利用、又沒對外暴露,排進一般更新週期即可。
客製化開發的系統要怎麼查漏洞?
不能只靠弱點掃描,因為掃描的原理是比對已知漏洞資料庫,而客製程式碼不在任何資料庫裡。客製的部分要用原始碼審查(人工或工具實際讀程式碼)或滲透測試(模擬攻擊實際試打)。很多公司拿到一份「無重大風險」的掃描報告就安心了,但如果系統有大量客製模組,那份報告其實沒檢查到最關鍵的地方。
用 AI 寫的程式安全嗎?
學術研究的結論偏向保守。除了生成的程式碼本身存在一定比例的安全弱點之外,更值得注意的是研究發現的「虛假安全感」——使用 AI 助手的開發者傾向把自己不安全的解法評為安全,因而減少了檢查。關鍵差別在於使用者:專業工程師用 AI 加速、看得懂輸出並知道要檢查什麼,跟不懂程式的人用 AI 生出整套系統,風險完全不同。
多久要檢查一次?
分兩個節奏。套件更新應該是例行工作,建議至少每月確認一次,重大安全更新則是公告後盡快處理;比較深度的檢查(原始碼審查或滲透測試)則綁在事件上而不是綁在時間上——上線前、重大改版後、串接新的金流或第三方服務時、或有合規要求時做。對中小企業來說,把每月更新做確實的效益,通常高於一年做一次深度檢查。
外包的程式要怎麼驗收才知道有沒有做好漏洞管理?
問四個具體問題:用到哪些第三方套件與版本(要一份清單)、上線後更新由誰負責且多久一次、客製部分有沒有經過程式碼審查且誰審的、將來爆出重大漏洞時的通知管道是什麼。這四題不需要技術背景就問得出來,而答案的具體程度會直接反映對方的管理成熟度。建議寫進交付清單,將來換廠商時這也正好是最需要的交接資料。
一直不敢更新套件,怕更新之後網站會壞掉,怎麼辦?
顧慮是合理的,但不更新的風險是會累積的:拖得越久,版本差距越大,將來非更新不可時(例如爆出重大漏洞必須緊急處理)一次要跨好幾個大版本,弄壞東西的機率反而比定期小步更新更高。正確的做法是先備份再更新、更新後實際把主要功能點過一遍,而不是不更新。如果有測試環境,先在測試環境更新過再上正式站更好。
參考資料
- ACM Transactions on Software Engineering and Methodology —《Security Weaknesses of Copilot-Generated Code in GitHub Projects: An Empirical Study》 https://dl.acm.org/doi/10.1145/3716848 (英文,國際,同儕審查期刊)
- Georgetown CSET —《Cybersecurity Risks of AI-Generated Code》 https://cset.georgetown.edu/wp-content/uploads/CSET-Cybersecurity-Risks-of-AI-Generated-Code.pdf (英文,美國,大學智庫研究報告)
- arXiv —《SOK: Exploring Hallucinations and Security Risks in AI-Assisted Software Development》 https://arxiv.org/pdf/2502.18468 (英文,國際,學術預印本,未經同儕審查)
- CISA(美國網路安全暨基礎設施安全局)—《Known Exploited Vulnerabilities Catalog》 https://www.cisa.gov/known-exploited-vulnerabilities-catalog (英文,美國政府機關官方清單)
- iThome —《資安界如何優化漏洞修補優先順序?教你快速搞懂CVSS、EPSS、KEV這三項指標》 https://www.ithome.com.tw/news/176987 (繁體中文,台灣科技媒體)
ℹ️ 關於本文
本文引用的漏洞評分機制(CVE、CVSS、EPSS)與已知遭利用漏洞清單(KEV)說明,以查閱當日(2026年9月13日)的公開資料為準,各機制的版本與收錄內容會持續更新,實際請以 MITRE、FIRST 與 CISA 的官方公告為準。關於 AI 生成程式碼的研究結論引自學術文獻,其中預印本尚未經同儕審查;模型版本更替快速,本文因此未引用特定模型的漏洞比例數字。文中對修補優先順序與檢查方式的判斷屬一般性實務經驗說明,實際情形會因系統架構、暴露程度與合規要求而有明顯差異,不構成資安評估建議。

關於作者|張安邦執行長
台灣大學醫學工程研究所背景,十年以上軟體開發經歷,領軍瞻新資訊有限公司(2010年成立),完成專案200+、涵蓋40~50+個產業。專長:網頁設計、APP開發、UI/UX設計、LINE Bot自動化、系統開發、資訊安全。

