作者|瞻新資訊 張安邦執行長(台大醫工背景・十年以上IT服務公司創辦人)
這兩年企業只要談到「導入 AI」,話題幾乎都繞著 ChatGPT 這類語言模型打轉。可是把需求攤開來看,很多公司要的其實是這種東西:符合哪些條件的訂單可以直接出貨、哪一級客戶打幾折、多少金額以上要主管簽核。
這些事不需要一個會聊天的模型。它們需要的是四十多年前就有的老技術:專家系統。
先講答案:專家系統沒有消失,它只是換了名字,現在多半叫規則引擎或決策表,很多公司每天都在用。 該問的不是它過時了沒有,而是哪些判斷該交給它,哪些該交給機器學習或語言模型。這篇寫給要做系統的企業主和專案窗口,不談考試會考的推論演算法。
專家系統是把專家的判斷寫成規則:知識庫加推論引擎
一句話定義:專家系統是把某個領域專家的判斷方法,寫成電腦可以一條一條照著跑的規則,讓電腦在那個範圍內做出接近專家的判斷。 因為靠的是人寫下來的規則,它也常被叫做規則式 AI。
中央研究院的臺灣人工智慧行動網對它的說明是:一種知識庫系統,用符號的方式把專家知識表達出來,再進行推論,解決特定領域的問題。這個概念起源於 1960 年代,常被視為由 Edward Feigenbaum 提出。
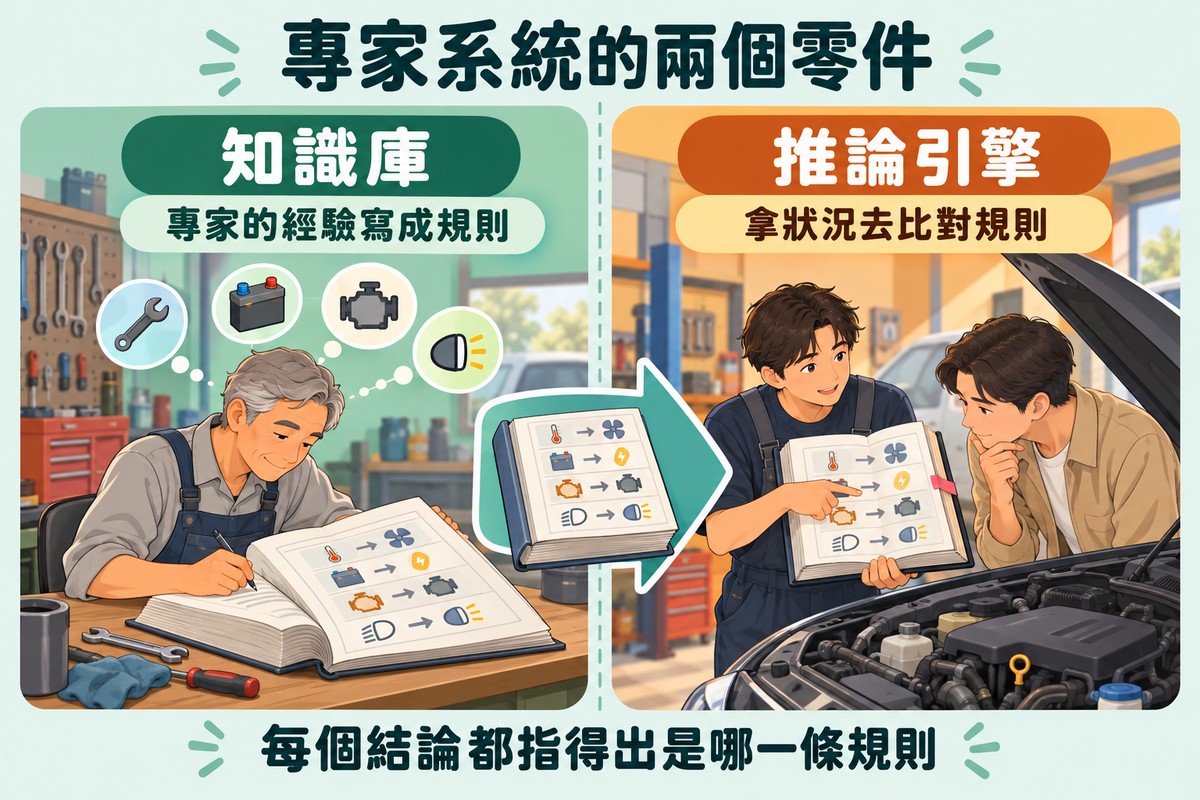
它有兩個主要零件:
- 知識庫:一條條「如果……就……」的規則,加上相關的事實
- 推論引擎:拿眼前的狀況去比對規則、得出結論的那段程式
拿修車廠來比。老師傅聽引擎聲就知道哪裡壞,那是他腦袋裡的經驗。把這些經驗寫成一本手冊,像是「如果發不動,而且大燈也不亮,就先查電瓶」,這本手冊就是知識庫。新來的學徒照手冊一條一條對,就是推論引擎在做的事。
學徒還有一個師傅沒有的優點:你問他為什麼這樣判斷,他翻得出是第幾頁第幾條。專家系統的每一個結論,都可以回頭指出是哪幾條規則推出來的。 這一點後面會變得很重要。
最有名的例子是 1970 年代史丹佛大學的 MYCIN,用來建議細菌感染該用哪種抗生素。1979 年刊在《美國醫學會雜誌》的一份盲測研究找了 8 位感染科專家,評 10 個腦膜炎病例的處方,評的時候不知道哪一份是電腦開的。結果 MYCIN 的處方有 65% 被評為可接受,同場 5 位感染科教授的平均是 55.5%。一個只靠規則的程式,在夠窄的範圍裡,確實做得到專家的水準。
順帶分清楚一個常被搞混的詞:決策支援系統是把資料整理好、交給人判斷;專家系統是把判斷本身寫進系統裡。
專家系統為什麼退燒:規則寫不完,也改不動
既然做得到專家的水準,為什麼後來很少人提?原因有兩個,都跟技術強不強無關。
第一,專家講不清楚自己是怎麼判斷的。老師傅「聽聲音就知道」,要他寫成條文,他寫不出來。中研院那份詞條也點出這個限制:專家系統只能處理可以寫成邏輯的知識,直覺、觸類旁通這類思考很難放進去。
第二,規則會越長越多,而且一直要改。迪吉多電腦公司(DEC)在 1980 年代用一套叫 XCON 的專家系統,替客戶訂的電腦搭配零件,當年在業界很有名。但 1987 年一篇檢討它怎麼維護的論文寫道:七年下來,XCON 長到 6,200 條規則,其中大約一半每年都要修改,而且越來越難改。
想像一本六千多條的公司規章,每年要改三千條,改這一條還可能牽動另外幾條。專家系統不是敗在不夠聰明,而是敗在維護:規則是活的,沒有人顧就會過期。
這個教訓到今天完全適用。要做規則系統,第一個要問的不是「怎麼寫」,而是「以後誰來改」。
專家系統沒有消失,現在叫規則引擎、決策表
「專家系統」這個詞後來比較少人用,但技術沒有走,只是換了名字,融進一般的企業系統裡。
你的公司很可能已經有好幾套:
- ERP 裡「採購金額超過多少要總經理簽核」
- 購物網站的折扣、滿額免運、哪些商品不能用優惠券
- 人資系統算加班費和特休
- 保險公司的承保審核、銀行的貸款條件
- 那份只有某位資深同事看得懂、塞滿 IF 公式的 Excel
這些全部是專家系統的後代:把人的判斷寫成規則,讓系統照著跑。 現在比較常聽到的名字是規則引擎(rules engine)、決策引擎,或業務規則管理系統。
規則的寫法也有國際標準。負責制定軟體標準的 OMG(Object Management Group)有一套 DMN 決策模型標準,用表格來寫規則:每一列是一種條件組合,最後一欄是結果。這份標準自己寫的首要目標,是提供一套所有業務人員都讀得懂的共同記法。換句話說,規則不該只有工程師看得懂,訂規則的那個人自己要能讀、能檢查。
所以與其問專家系統還有沒有用,不如問:公司裡這麼多判斷,哪些繼續寫成規則,哪些該換別的做法?
規則式 AI、機器學習、大型語言模型差在哪
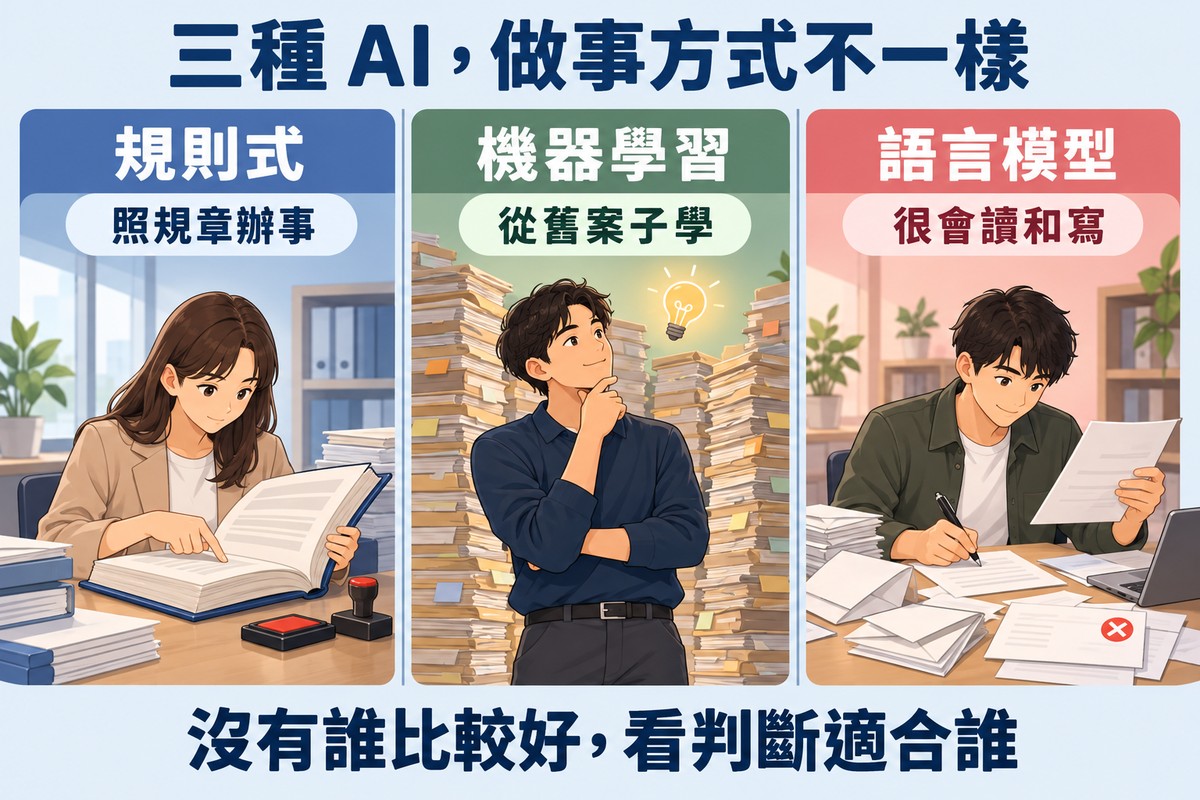
先把三種做法分開。它們都被叫做 AI,做事的方式卻完全不同。 用公司裡的三種人來比:
- 規則式(專家系統)像照規章辦事的承辦人。規章怎麼寫他就怎麼做,問他為什麼,他翻得出條文
- 機器學習像看過一萬個案子的老業務。他說「這個客戶會跑」通常很準,但問他為什麼,他只說得出「感覺」
- 大型語言模型像很會讀、很會寫的新同事。信件、合約、客訴他都看得懂,回覆也寫得漂亮,但偶爾會很有自信地講錯
| 比較 | 規則式(專家系統) | 機器學習 | 大型語言模型 |
|---|---|---|---|
| 判斷從哪裡來 | 人一條一條寫 | 從歷史資料學出來 | 從大量文字學出來 |
| 同樣的輸入 | 每次結果都一樣 | 模型不換就一樣 | 可能每次不太一樣 |
| 說得出理由嗎 | 可以,指得出哪一條 | 多半只能事後推估 | 會給理由,但不保證可靠 |
| 最怕什麼 | 規則寫不完、沒人維護 | 歷史資料不夠 | 自信地講錯 |
三種做法沒有誰比較新、誰比較好,只有適不適合手上這個判斷。 把不適合的判斷硬交給其中一種,問題就來了。
哪些業務判斷該寫成規則:事後要說得出理由的
判斷的方法只有一句:事後會不會有人來問「為什麼」?會,就寫成規則。
問的人可能是客戶(為什麼我不能退貨)、員工(為什麼我的獎金比他少)、會計師或主管機關(這筆為什麼這樣算)。只要有人會問,而你必須答得出來,這個判斷就該有白紙黑字的規則。 系統照規則跑,每一次都留下紀錄。
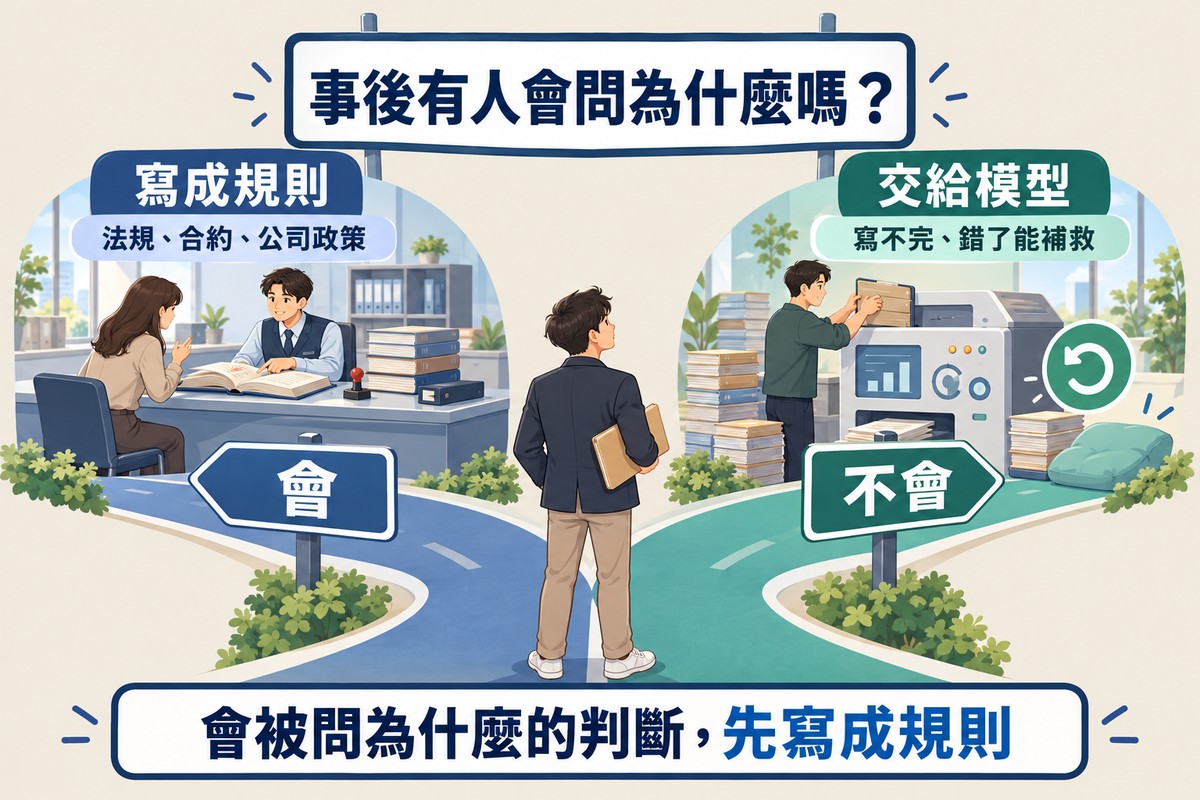
符合下面任何一項的判斷,適合寫成規則:
- 依據是法規、合約或公司政策:加班費、退換貨條件、保固範圍、折扣權限
- 同樣情況必須同樣結果:不能今天准、明天不准
- 條件數得出來:三五個欄位就能講完,不必靠感覺
- 錯一次代價很高:牽涉金額、資格、權益
「說得出理由」這件事,法規也在往這個方向走。台灣的《人工智慧基本法》在 2026 年 1 月 14 日公布施行,第 4 條列出的原則裡就有「透明與可解釋」和「問責」。它規範的是政府怎麼推動 AI,沒有直接對民間企業課義務,但方向很清楚。金融業更具體一點:金管會 2024 年 6 月發布的《金融業運用人工智慧(AI)指引》屬於行政指導,裡面要求金融機構要能清楚說明 AI 系統怎麼運作,以及預測或決策背後的邏輯。
2026 年 7 月,數位發展部也依這部法公布了 AI 風險分類框架,讓各部會用同一套流程(盤點應用情境、識別風險、評估風險、應對風險)去訂自己主管產業的管理規範。各行各業的具體規定還在陸續出來,現在先把判斷的依據和紀錄留好,之後要補的功課會少很多。
國外有的直接寫進法規。美國管銀行放款的法規 Regulation B 要求,拒絕貸款申請時給的理由必須具體、指出主要原因,只說「未達內部標準」或「信用評分不夠」不算數。這是美國的規定,台灣沒有一模一樣的條文,但它點出同一件事:越是影響別人權益的決定,越不能只回一句「系統算出來的」。
⚠️ 注意
不要因為「AI 比較厲害」就把有明文依據的判斷交給模型。退貨資格、折扣權限、薪資計算這類事情,模型答對九十九次也不夠,客戶和員工只會記得答錯的那一次,而且你說不出它為什麼錯。
哪些判斷適合交給機器學習或大型語言模型
規則的極限前面講過:寫不完、改不動。反過來說,下面三種情況就不要硬寫規則。
第一種,條件多到寫不完,但有很多歷史結果可以學。 例如哪些客戶快要流失、這筆交易像不像盜刷、首頁該推哪些商品。這類判斷牽涉的條件有幾百個,彼此還會互相影響,人寫不出來,讓機器學習從過去的資料裡找規律比較實際。推薦系統就是典型的例子。
不過順序很重要。Google 的工程師寫過一份機器學習實務守則,第一條就是:不要害怕推出一個沒有機器學習的產品。理由是機器學習需要資料,還沒有資料的時候,簡單的規則反而好用。第三條接著說:規則變得太複雜、難以維護的時候,就該改用機器學習。先用規則上路,等規則多到顧不來、資料也累積夠了,再換成模型。 該換的訊號有兩個:同一類判斷的規則,已經多到每改一條都怕牽動別條;而且手上累積了夠多「當時怎麼判、後來結果如何」的紀錄。
第二種,輸入是人話或文件。 客人在 LINE 上打了一長串抱怨、供應商寄來格式都不一樣的報價單、一份三十頁的合約。規則處理不了這種東西,語言模型卻很擅長:它可以讀懂、分類、把重點抓成欄位。語言模型怎麼接進公司的系統,可以看 ChatGPT API 的導入說明。
但語言模型有一個先天的毛病。美國國家標準暨技術研究院(NIST)在生成式 AI 的風險文件裡把它叫做 confabulation,白話說就是一本正經地講錯:系統會很有自信地給出錯誤或不實的內容。文件還說,這是這類模型設計方式的自然結果。換句話說,它不是偶爾才出的故障。
2024 年加拿大有一個案子常被拿出來討論。根據澳洲法律專業媒體的報導,加拿大航空網站上的聊天機器人告訴一位旅客,喪親優惠票可以先買一般票、事後再申請退差價,但公司的政策其實不能事後申請。旅客告到卑詩省的民事審裁處。航空公司主張機器人說的話不該由公司負責,審裁員沒有接受,認為公司要對自己網站上的所有資訊負責。這是加拿大的個案,不代表台灣會怎麼認定,但值得想一想:讓語言模型直接回答「公司政策是什麼」,等於讓它替公司做承諾。
第三種,錯了可以補救。 推薦錯一個商品,客人滑過去就算了;判錯一筆退款資格,就是一件客訴。模型適合做「錯了代價不高、對了很有幫助」的判斷。
專家系統與現代 AI 怎麼搭配:模型給分數,規則做決定
真的動手做的時候,很少是二選一。比較穩的做法是疊起來用,各做各擅長的事:
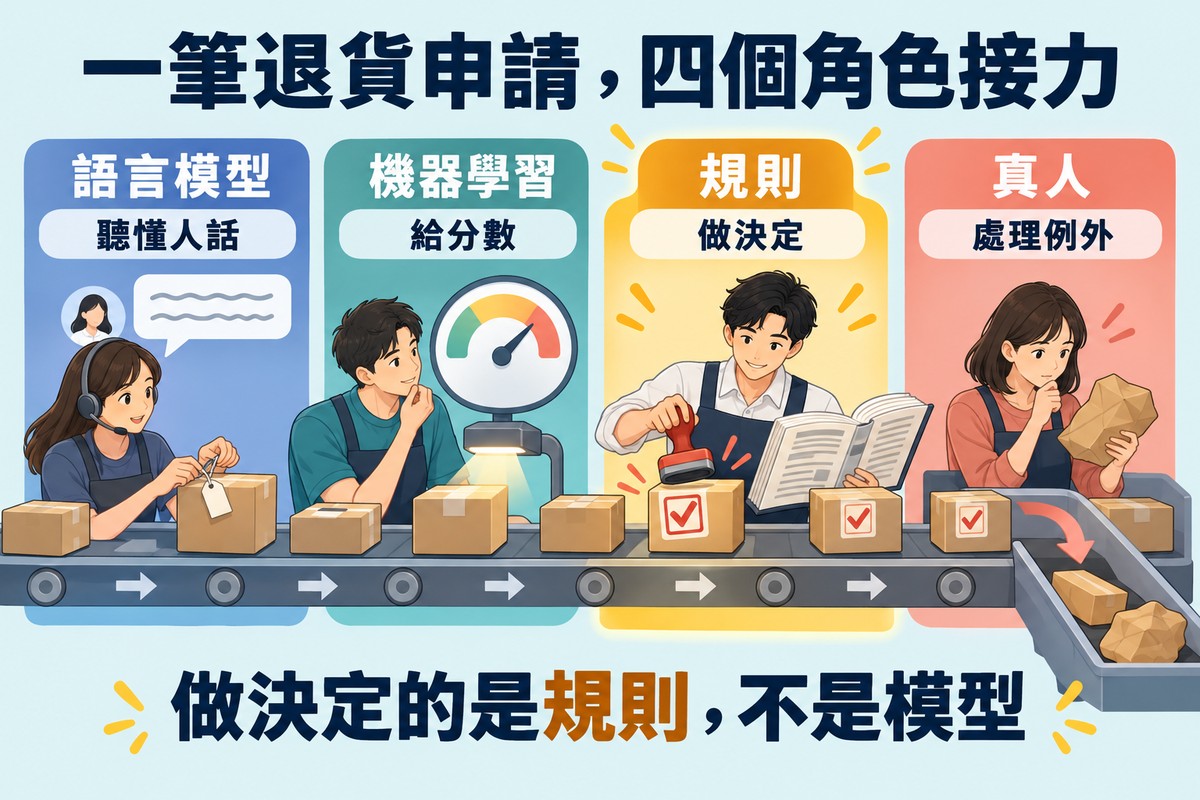
語言模型負責聽懂,機器學習負責給分數,規則負責做決定,人負責處理例外。
假設一家網路商店要處理退貨申請,流程可以這樣排:
- 客人傳來一段話。語言模型讀懂它,抓出訂單編號、商品和退貨原因
- 機器學習模型看這位客人過去的紀錄,給一個「異常退貨」的風險分數
- 規則引擎照公司的退貨政策判斷:有沒有超過期限、這類商品能不能退、風險分數有沒有超過門檻
- 符合規則的直接核准;卡在邊界或分數偏高的,轉給真人
- 語言模型把結果寫成客人看得懂的回覆,裡面的理由來自第 3 步命中的那條規則
注意第 3 步。做決定的是規則,不是模型,模型的分數只是規則的其中一個輸入。 這樣一來,客人問「為什麼不能退」,你答得出是哪一條;想調整政策,改的是規則,不用重新訓練模型。
電商的商品推薦也是同一個結構:模型排出推薦順序,業務規則再把缺貨的拿掉、把檔期主打的往前排,細節可以看商品推薦系統怎麼佈局。
搭配也可以反過來。把一疊舊公文、合約和內規丟給語言模型,請它整理成規則的草稿,可以省掉不少整理的工夫。但草稿就是草稿,每一條都要由負責那條規則的人看過、點頭,才能放進系統。
💡 小提醒
疊在一起用的時候,記得把每一次判斷的輸入、命中的規則、規則版本和結果都記下來。半年後有人來問,才查得到當時系統是照哪一版規則判的。
企業要做規則引擎或決策系統,先準備這六件事
我最常聽到客戶說的一句話是:「我知道我需要一個系統,但我說不清楚要做什麼。」做規則系統的時候,這句話會換一個版本:規則都在幾位資深同事的腦袋裡,就是寫不出來。這很正常。下面六件事,就是把腦袋裡的東西搬到紙上的順序。
- 把判斷點列出來。 一條流程裡,哪幾個地方有人在做決定?流程本身怎麼畫可以參考 BPM 系統那一篇,這裡要找的是流程裡每一個「要看情況」的節點
- 每條規則找到依據和負責人。 依據是法規、合約,還是某位主管的習慣?以後誰有權改它?找不到負責人的規則,上線之後沒有人敢動
- 寫成決策表,讓訂規則的人自己看得懂。 一列一種情況。三個人對同一件事有三種說法,這時候就會浮出來
- 先講好例外怎麼辦。 規則沒涵蓋到的情況交給誰?誰可以破例?破例要不要留紀錄?
- 規則要有版本和生效日,每次判斷都要留紀錄。 下個月調折扣,舊訂單還是要照舊規則算
- 拿過去的案件來測,並且控制規則的數量。 把去年的一百筆真實案件丟進去,看系統判的跟當時的人判的一不一樣
最後一點多說一句。軟體架構專家 Martin Fowler 在談規則引擎的文章裡提醒:規則一多、一條觸發另一條,整套系統在做什麼就沒有人看得懂。他的建議是限制規則的數量、少讓規則互相觸發,而且不一定要買現成的產品,自己做一個只在這個小範圍用的也行。這跟 XCON 的教訓是同一件事:規則系統的成本不在第一天,在往後的每一次修改。
至於要花多少錢,沒有通用的數字,主要看四件事:規則有幾條、例外多不多、要接幾套既有系統、以後由誰維護規則。
專家系統留給這個產業的,其實不是怎麼模仿專家,而是「判斷要寫下來才管得住」。 語言模型再厲害,也不會替你決定公司的退貨政策。先把規則寫清楚,再來談哪一段可以交給模型。
如果你手上有一堆判斷散在 Excel 和幾位資深同事的腦袋裡,想整理成系統卻不知道從哪裡開始,瞻新資訊可以先陪你把判斷點和規則盤一遍,再決定哪些寫成規則、哪些交給模型。
常見問題
專家系統是什麼?
專家系統是把特定領域專家的判斷方法寫成規則,讓電腦在那個範圍內做出接近專家的判斷。 它主要由存放規則的知識庫,和拿規則去比對狀況的推論引擎組成,屬於早期人工智慧的一支。
專家系統現在還有人用嗎?
有,只是不太叫這個名字。現在的規則引擎、決策表、ERP 裡的簽核條件、電商的折扣規則,都是專家系統的延伸。 凡是事後要說得出理由的判斷,寫成規則仍然是最穩的做法。
專家系統跟機器學習差在哪?
專家系統的規則是人寫的,機器學習的規律是從資料學出來的。 前者說得出每個結論的理由,但規則要有人維護;後者能處理寫不完的複雜情況,但需要大量歷史資料,理由也比較難交代。
專家系統會被 ChatGPT 這類語言模型取代嗎?
不會整個被取代。語言模型擅長讀懂和寫出人話,但不適合做需要每次一致、說得出依據的最後決定。 比較常見的做法是讓語言模型負責理解和說明,決定本身仍由規則來做。
專家系統跟決策支援系統有什麼不同?
決策支援系統把資料整理成報表或分析,最後由人判斷;專家系統是把判斷的規則直接寫進系統,由系統得出結論。 一個幫人看清楚狀況,一個替人照規則下判斷。
中小企業要做規則引擎,一定要買專門的軟體嗎?
不一定。規則不多、範圍明確的時候,把規則整理成決策表、寫進現有系統裡就夠用;規則多、常常要改,又希望業務人員自己維護時,才值得評估專門的規則引擎。 先把規則寫清楚,比先選工具重要。
參考資料
- Expert System — 臺灣人工智慧行動網(中央研究院法律學研究所)(繁體中文,台灣,2026-10-09 查證)
- Antimicrobial selection by a computer. A blinded evaluation by infectious diseases experts — Yu VL 等,JAMA,1979;242(12):1279-82(英文,美國,2026-10-09 查證)
- Assessing the Maintainability of XCON-in-RIME: Coping with the Problems of a VERY Large Rule-Base — Soloway、Bachant、Jensen,AAAI-87 論文集,1987(英文,美國,2026-10-09 查證)
- Decision Model and Notation (DMN) 1.5 — Object Management Group,2024-08(英文,全球,2026-10-09 查證)
- 人工智慧基本法 — 全國法規資料庫,115-01-14 公布(繁體中文,台灣,2026-10-09 查證)
- 金管會發布「金融業運用人工智慧(AI)指引」 — 金融監督管理委員會,2024-06-20(繁體中文,台灣,2026-10-09 查證)
- AI 風險分類框架 — 數位發展部,頁面更新 2026-07-08(繁體中文,台灣,2026-10-09 查證)
- 12 CFR § 1002.9 Notifications(Regulation B) — 美國消費者金融保護局(英文,美國法規,2026-10-09 查證)
- Rules of Machine Learning — Martin Zinkevich,Google for Developers,頁面更新 2025-08-25(英文,全球,2026-10-09 查證)
- Artificial Intelligence Risk Management Framework: Generative AI Profile(NIST AI 600-1) — 美國國家標準暨技術研究院,2024-07(英文,美國,2026-10-09 查證)
- Air Canada forced to honour chatbot offer — Law Society Journal(新南威爾斯律師公會),2024-02-20(英文,澳洲媒體報導加拿大案件,新聞時事,2026-10-09 查證)
- RulesEngine — Martin Fowler,2009-01-07(英文,全球,具名專家觀點,2026-10-09 查證)
ℹ️ 關於本文
本文引用的論文、標準文件、法規與官方指引,以查閱當日(2026 年 10 月 9 日)各來源網站的版本為準;法規與主管機關的指引可能修正,實際請以各來源的最新內容為準。文中對哪些判斷適合寫成規則、哪些適合交給模型的說明,屬一般性的實務經驗整理,實際情形會因產業、既有系統與資料狀況而有明顯差異,不構成任何成本、時程或成效的保證,也不是法律意見。引用的國外研究、法規與個案為各該國家或機構的情況,不代表台灣現況。

關於作者|張安邦執行長
台灣大學醫學工程研究所背景,十年以上軟體開發經歷,領軍瞻新資訊有限公司(2010年成立),完成專案200+、涵蓋40~50+個產業。專長:網頁設計、APP開發、UI/UX設計、LINE Bot自動化、系統開發、資訊安全。

