作者|瞻新資訊 張安邦執行長(台大醫工背景・十年以上IT服務公司創辦人)
「我們想每天抓三家同業的價格做比價表」「想把某個網站的資料整批撈下來分析」——這類需求,十個有九個第一句就是:找人寫一支爬蟲程式。我懂,因為資料看起來就擺在那裡。
先講一件很多人不知道的事:在台灣,用程式抓別人網站上的資料,已經有公司因此吃上刑事官司——不是罰錢了事,是刑事責任。所以「爬蟲會不會出事」這個問題,值得在動手之前先想清楚。
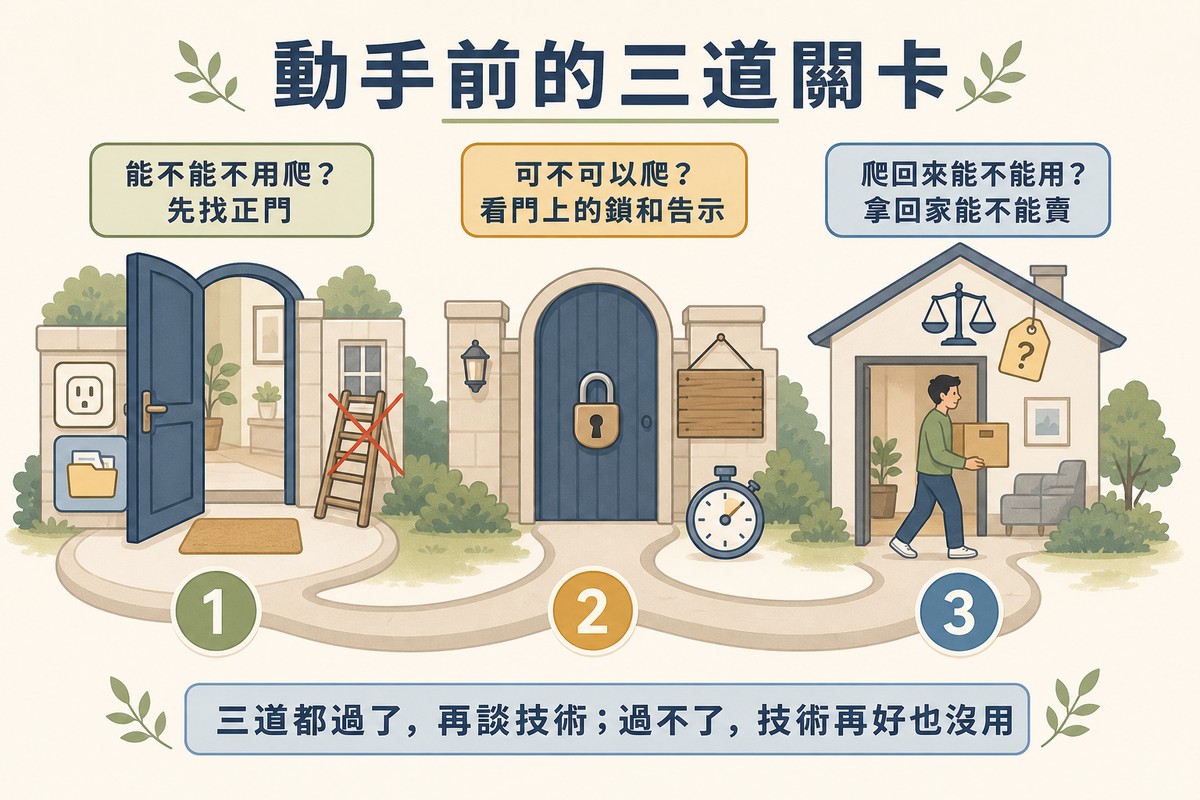
這篇文章不教你寫程式,也不是要嚇你別做。它要講的是動手之前的三道關卡:能不能不用爬、可不可以爬、爬回來能不能用。三道都過了,再談技術;過不了的,技術再好也沒用。
先講結論:爬蟲程式是最後手段,不是預設手段
先把名詞講白。爬蟲程式(web crawler/web scraper)是一種自動化程式:它替你打開網頁、把上面的內容抓下來、整理成表格或資料庫。 Google 的搜尋引擎爬蟲也是同一個原理,差別只在誰在用、拿來做什麼。
它很誘人,因為看起來「資料就在那裡,抓下來就好了」。做過的人都知道,爬蟲程式從來不是最省事的路,它只是看起來最省事。它沒有授權、格式不穩、對方改版就壞,而且每一步都可能碰到法律問題。
所以我的建議一直是:爬蟲是最後手段。 動手前照順序過三道關卡:
| 關卡 | 要問的問題 | 過不了會怎樣 |
|---|---|---|
| 第一道 | 能不能不用爬?有沒有開放資料、API、供應商、談授權的可能? | 有正門還爬窗,就是把自己放進最不利的位置 |
| 第二道 | 可不可以爬?要登入嗎、條款怎麼寫、robots.txt 怎麼說、頻率會不會造成負擔? | 可能碰到刑法妨害電腦使用罪或民事違約 |
| 第三道 | 爬回來能不能用?著作權、個資、公平交易怎麼看? | 抓得到不代表用得了,用了才是出事的開始 |
用一個比喻:第一道看有沒有正門,第二道看門上有沒有鎖和告示,第三道看東西拿回家之後能不能賣。 下面一道一道講。
一句話收尾:爬蟲程式是最後手段;三道關卡照順序過,過不了就別碰。
第一道關卡:能不能不用爬?先找正門
這一道最常被跳過,偏偏最重要。很多資料其實有正規管道,只是沒人去找。
政府資料先看開放平臺。 台灣的「政府資料開放平臺」由數位發展部維運,有專門的 API 服務資料集專區;它的授權條款第 1 版寫得很清楚:可以重製、散布、編輯、改作,包含商業目的,條件是要依規定標示原資料提供機關——沒標示的話,視為從頭就沒取得授權。也就是說,抓政府開放資料最大的風險不是爬,是忘了標出處。
對方有 API 就走 API。 很多平台本來就提供程式介面讓你合法取資料,格式穩定、有版本、有授權範圍。如果你對 API 這個詞還不熟,站上API 是什麼那篇有講。用 API 拿到的資料有授權文件可以對,用爬蟲抓的沒有,這在出事的時候差別很大。
資料供應商與直接談授權。 商品資料、公司資料、房價這類,市場上有專門整理好賣的;或者你直接寫信問對方能不能給。這一步很多人覺得麻煩,但比起後面的風險,寫一封信真的不算什麼。
舉個常見的情境:一家零售商想每天抓三家同業的價格做比價表。先問正門——同業當然不會給你 API,但價格資訊有沒有第三方的比價平台或市調資料可以買?有的話,那筆錢通常比自己養一支每週被對方改版弄壞的爬蟲便宜。真的沒有,才進第二道關卡。
回頭看開頭那個案子最刺眼的一點:那家公司是對手網站的付費會員,有正規的付費管道,卻用程式整批下載。有正門,還爬窗,這是法院看得最重的事之一。
一句話收尾:先找正門——開放資料、API、供應商、談授權;有正門還爬窗,是最不利的起點。
第二道關卡:可不可以爬?看四扇門
假設第一道過了,資料真的沒有正規管道。第二道關卡看的是「你怎麼進去」,有四扇門要一扇一扇檢查。
第一扇:要不要登入或付費? 這是最硬的一條線。刑法第 358 條處罰「無故輸入他人帳號密碼、破解使用電腦之保護措施或利用電腦系統之漏洞」入侵他人電腦;第 359 條處罰「無故取得、刪除或變更他人電腦或其相關設備之電磁紀錄,致生損害於公眾或他人者」,最高五年以下。資料在登入牆或付費牆後面,就不是「公開資料」,用程式繞過去或超出授權範圍整批拿,就是在這兩條的射程裡。
第二扇:使用條款怎麼寫? 多數網站的服務條款都寫了「禁止自動化擷取」。在台灣,違反條款本身是民事的契約問題;而在台灣已經發生的案件裡,法院也把「違反網站公告的使用規範」列入整體判斷——條款不是純粹的君子協定,它會成為判斷你「有沒有故意」的材料。國外也一樣:美國 hiQ 對 LinkedIn 的案子,法院雖然認為抓公開網站不構成美國電腦詐欺法的「未經授權」,但 2022 年的和解確認了網站條款裡「禁止爬取」的約定可以依違約請求執行,hiQ 被判 50 萬美元並禁止再爬。(這是美國法下的結果,只能對照,不能套到台灣。)
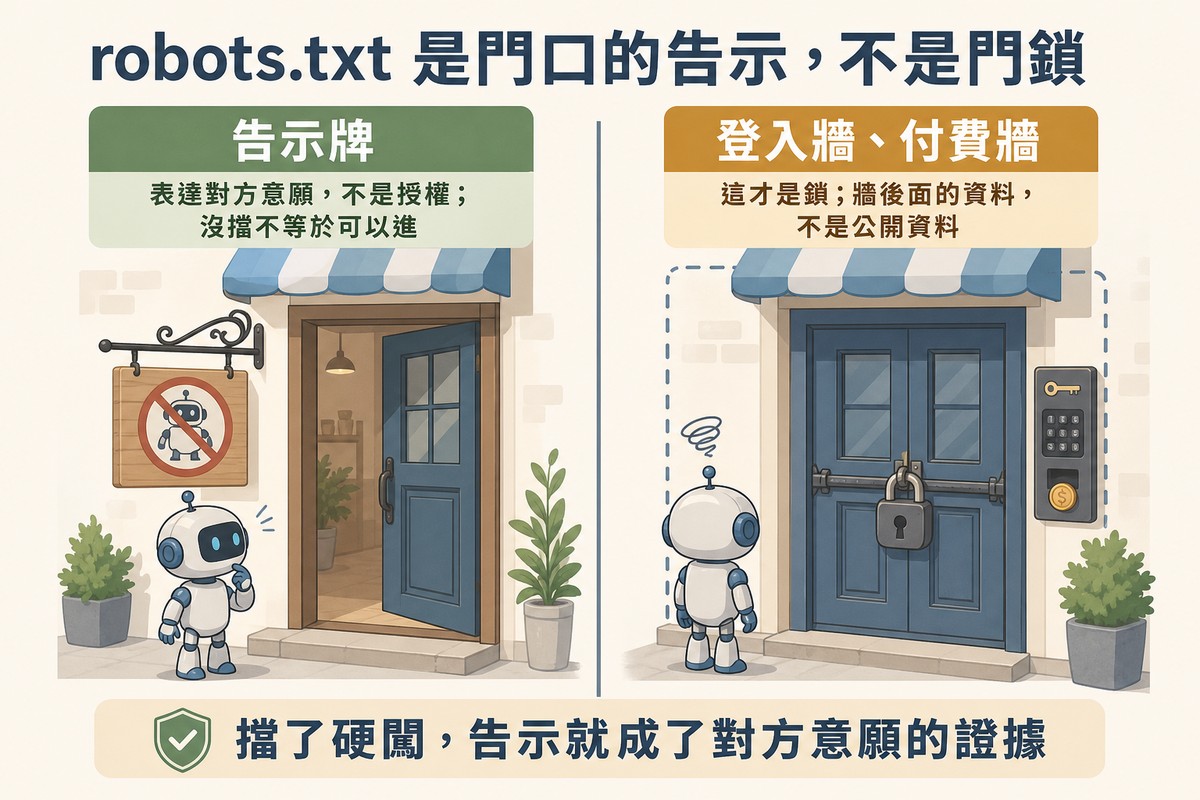
第三扇:robots.txt 怎麼說? 這裡有一個常見誤解。robots.txt 是網站放在根目錄的一個文字檔,寫明哪些路徑不希望爬蟲進來;它在 2022 年正式成為網路標準 RFC 9309。標準原文講得很直接:這些規則「不是一種存取授權」,也「不能取代有效的內容安全措施」。換句話說,robots.txt 是門口的告示牌,不是門鎖。沒擋,不代表你可以任意進;擋了你硬闖,不會直接違法,但它成了對方意願的證據,出事時對你很不利。RFC 還規定:抓不到 robots.txt(伺服器錯誤)的時候,爬蟲必須當成全部禁止;快取的 robots.txt 不應超過 24 小時,也就是說對方的規則會變,你的爬蟲要定期重讀,不是寫死。實務上還有一個減少誤會的做法:在請求裡誠實標示自己是誰(程式名稱、聯絡方式),對方有問題找得到人,比被當成攻擊流量直接封鎖好。如果你是網站方想知道自己該怎麼設,站上Robots.txt 與 Meta Robots那篇講的是這一面。
第四扇:頻率與負擔。 一支寫壞的爬蟲,一秒打幾十次請求,對方網站可能就慢了或掛了。刑法第 360 條處罰「無故以電腦程式或其他電磁方式干擾他人電腦」致生損害。抓取頻率不只是禮貌問題,是法律問題;合理的做法是拉開間隔、避開尖峰、有快取就用快取。
⚠️ 注意
第 358 到 360 條依第 363 條是告訴乃論,也就是要對方提告才會啟動。這不是安全感的來源——你抓的量越大、對方越像競爭對手,對方提告的動機就越強。 實際適用請以法律專業意見為準。
一句話收尾:四扇門:登入牆、條款、robots.txt、頻率;資料在牆後面就不是公開資料,告示牌不是通行證。
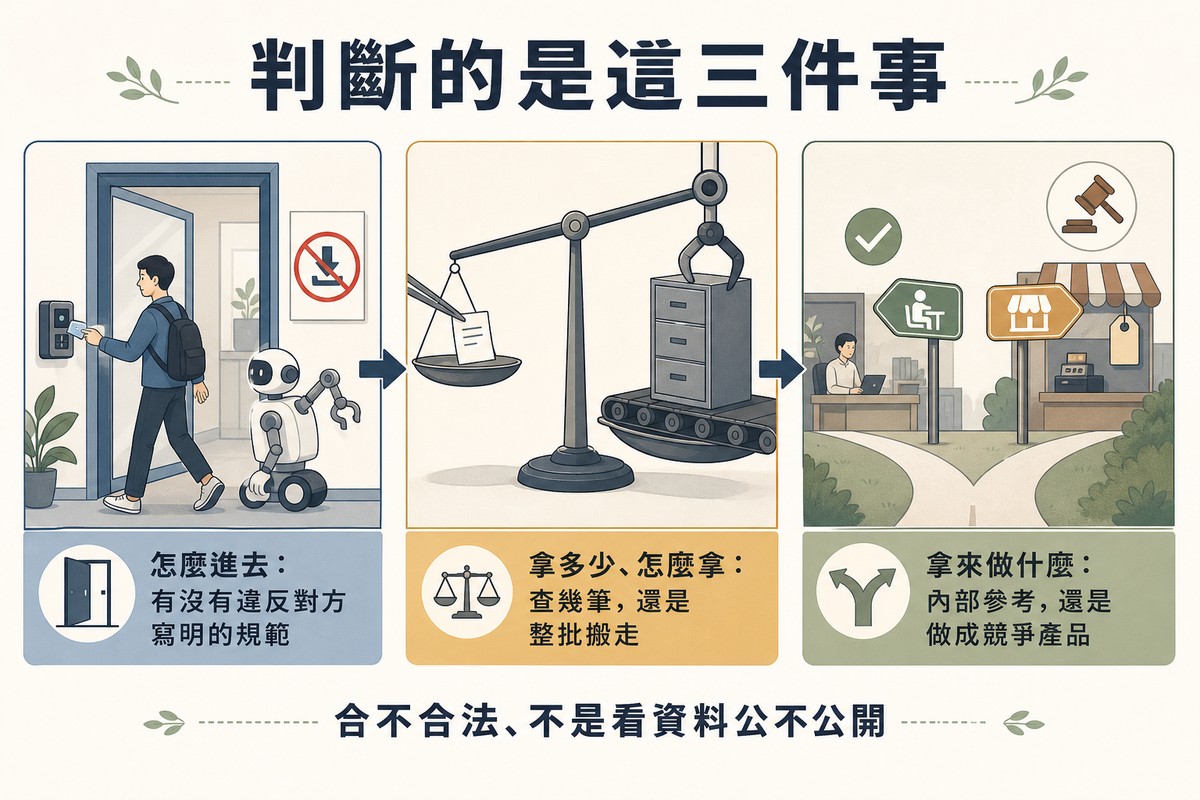
判斷的不是資料公不公開,是這三件事
台灣已經有公司因為用程式大量抓取他人網站的資料庫內容、拿去做自家產品,而被依著作權法與刑法判刑的實際案例。所以這不是理論上的風險。
但與其記住某一個案子,不如記住它背後的判斷邏輯。合不合法,不是看資料公不公開,是看這三件事:
一、怎麼進去。 有沒有登入、有沒有違反對方明確寫出來的使用規範。用合法身分進去、卻做了規範明確禁止的事,比從外面抓一個公開頁面嚴重得多。
二、拿多少、怎麼拿。 手動查個幾筆,跟用程式整批把一個資料庫搬走,法律評價完全不同。「整批重製」是這類案件裡的關鍵字。
三、拿來做什麼。 內部參考、學術研究,跟做成一個跟對方競爭的產品對外販售,中間距離非常遠。著作權法對「意圖銷售」而重製他人著作,訂有更重的罰則。
還有一個很多人想不通的點:原始資料是公開的,怎麼還會侵權?
關鍵在著作權法第 7 條的編輯著作——「就資料之選擇及編排具有創作性者為編輯著作,以獨立之著作保護之」。原始資料誰都能用,但別人花時間金錢整理、編排出來的成果,是另一回事。
用一句話記:食材是公共的,別人排好的菜單不是。
一句話收尾:合不合法不是看資料公不公開,是看怎麼進去、拿多少、拿來做什麼。
第三道關卡:爬回來能不能用?著作權、個資、公平交易
假設前兩道都過了:資料沒有正規管道、不用登入、條款沒禁止、頻率合理。第三道關卡問的是:抓得到,不代表用得了。
| 你抓的是什麼 | 主要看哪條 | 判斷重點 |
|---|---|---|
| 別人寫的文章、圖片、商品描述 | 著作權法 | 整篇重製拿去用,幾乎過不了合理使用 |
| 別人整理編排過的資料庫、清單、沿革 | 著作權法第 7 條編輯著作 | 資料本身公開,編排仍受保護 |
| 純粹的事實與數字(價格、庫存、時刻) | 著作權法第 9 條、第 65 條 | 事實本身不受保護,但整批抓取的方式與用途仍要看 |
| 姓名、電話、評論者身分等 | 個資法第 19、20 條 | 要有特定目的與合法要件,且只能在目的內利用 |
| 直接拿去做跟對方相同的產品 | 公平交易法 | 律師實務上把「不公平競爭」列為獨立風險 |
回到那家想做比價表的零售商,第三道關卡會把需求切成三塊:抓「價格」是事實,本身不受著作權保護;抓「商品描述和圖片」是表達,整批搬過來幾乎過不了合理使用;抓「評論者的名字和留言」是個資,要有特定目的與合法要件。 同一支爬蟲,三種資料三種答案。
著作權這一格,先分事實和表達。 價格、庫存、營業時間這種事實本身不受著作權保護;但商品描述、評論、文章是表達,整篇抓下來放到自己網站,依第 65 條第 2 項的四項基準(利用目的與性質、著作性質、利用比例、對市場的影響),商業目的加整批重製加取代對方市場,四項幾乎全部不利。
個資這一格,有一個常見誤解。 很多人以為「網頁上看得到的個資就是公開的,可以抓」。個資法第 19 條第 1 項確實列了「當事人自行公開或其他已合法公開之個人資料」與「取自於一般可得之來源」兩款,但條文同時要求要有特定目的,而且第 7 款有但書:當事人對該資料有更值得保護的重大利益者,不在此限;第 20 條再加一層:利用只能在蒐集的特定目的必要範圍內。抓一批評論者的名字和留言去做行銷名單,這幾條幾乎每一條都會碰到。
公平交易這一格,比較少人講。 台灣有律師把爬蟲的法律風險整理成五個面向——著作權、個資、公平交易法、服務條款違約、刑法——並指出如果沒有實質轉化利用,直接拿別人的資料做相同或類似的服務,容易被認定為足以影響交易秩序的顯失公平行為。這是律師的實務見解,不是判例,但值得放進評估。
💡 小提醒
一個實用的自問句:「如果對方明天發現了,我有沒有辦法解釋這批資料為什麼是我的?」 答得出「授權文件」「開放資料條款」「只用了事實、沒用表達、量很小、用途跟對方不競爭」的,通常沒問題;答不出來的,就是第三道關卡沒過。
一句話收尾:抓得到不代表用得了:事實可以、表達不行、編排不行、個資要有目的、別拿去做對方的生意。
三道關卡都過了,才談技術路線
到這裡才輪到「怎麼寫」。這一段回答最常被問的兩題:要不要學 Python、有哪些套件。
| 路線 | 適合什麼 | 工具舉例 | 代價 |
|---|---|---|---|
| 現成工具(瀏覽器插件、SaaS) | 一次性、量小、頁面單純、不會寫程式 | 各種點選式擷取工具 | 客製彈性低、對動態頁面常失效 |
| 腳本(Python) | 來源固定、要定期跑、資料就在網頁原始碼裡 | requests 取頁面+BeautifulSoup 解析 | 要有人維護 |
| 瀏覽器自動化 | 內容靠 JavaScript 載入、要捲動或點擊才出現 | Playwright、Selenium | 慢好幾倍、資源吃重 |
| 框架 | 多來源、大量、要排程、例外處理、匯出 | Scrapy(可搭配 Playwright) | 學習與建置成本高 |
判斷順序其實很簡單:
- 資料在原始碼裡嗎? 用瀏覽器「檢視原始碼」找得到那些字,就是靜態頁,requests 加 BeautifulSoup 就夠;找不到、要等頁面載入才出現,就是動態頁,要用瀏覽器自動化,成本高數倍。
- 來源幾個、多久跑一次? 一個來源每週跑一次,腳本;十個來源每小時跑,框架。
- 誰維護? 這一題決定一切,下一節講。
要不要學 Python?如果你只是要做一次性的小量擷取,現成工具就夠,不用學;如果這件事會變成公司的例行流程,Python 是目前生態最完整的選擇,但真正該投資的不是語法,是上面三道關卡的判斷力。現在用 AI 工具產生一支能跑的爬蟲很快,AI 不會替你過三道關卡,也不會替你維護;站上為什麼找專業工程師開發系統,比自己用 AI 做更重要那篇講的正是這個落差。
一句話收尾:靜態頁用腳本、動態頁用瀏覽器自動化、多來源大量用框架;先看資料在不在原始碼裡。
真正的成本在維護,不在開發
做過爬蟲專案的人聽到這句都會點頭;還沒做過的人,多半會低估。
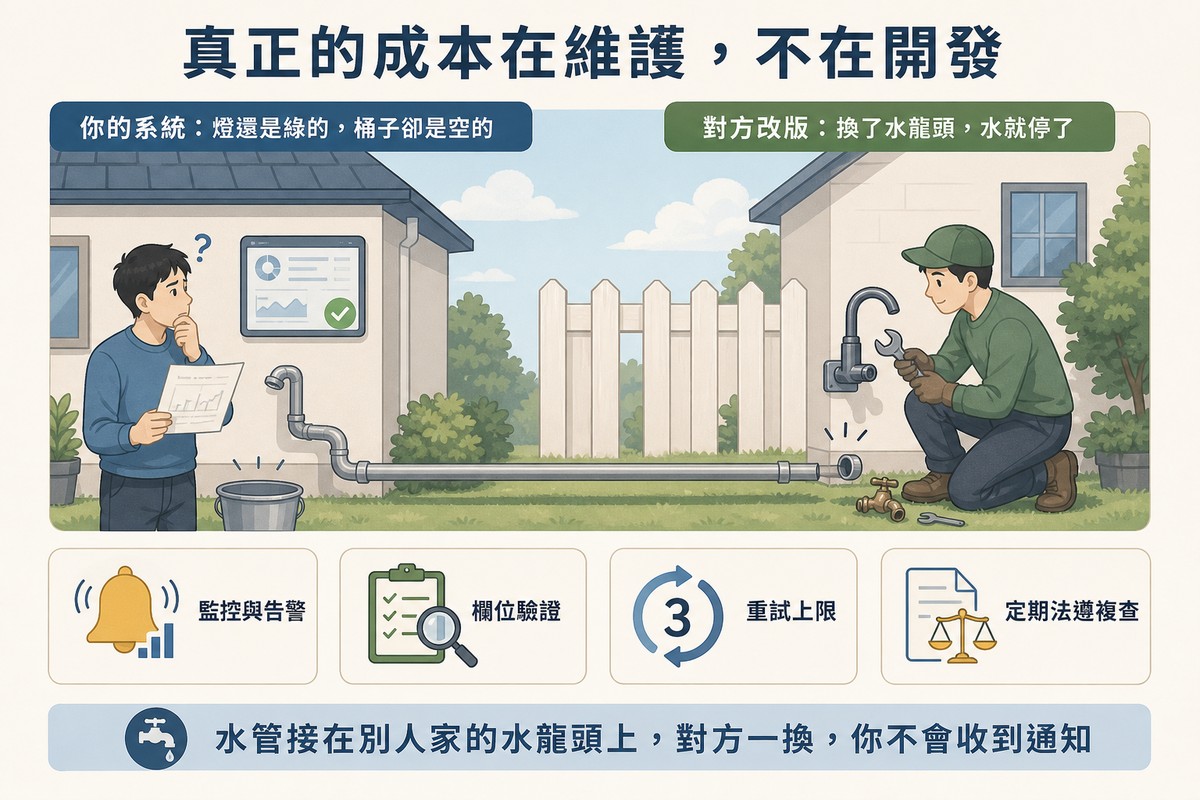
爬蟲程式的水管,是接在別人家的水龍頭上的。 對方今天改版、換了頁面結構、加了驗證碼、調了網址,你的水就停了。而且它不會告訴你——它可能還是每天跑、每天回報成功,只是抓回來的是空白或錯的欄位,直到有人拿報表去用才發現。
算一筆帳(用約數):開發一支中等複雜度的爬蟲是一次性的工,假設是一到兩週;但目標網站一年改版幾次很正常,每改一次你就要修一次,再加上驗證碼、封鎖 IP、動態載入這些反爬蟲手段的演變,兩年下來,維護的總工時通常會超過當初開發的好幾倍。這還沒算資料錯了沒人發現造成的決策損失——比價表上某家同業的價格三個月前就沒更新,而你一直照那個數字定價。
所以一個像樣的爬蟲專案,開發只是開頭,至少還要有:
- 監控與告警:抓回來的筆數、欄位空值比例異常就通知,不是「跑完就好」
- 欄位驗證:價格突然變成 0 或變成一串文字,要擋下來
- 排程與重試:失敗要重試、重試要有上限,不要變成第二道關卡裡的「干擾」
- 法遵複查:對方條款改了、robots.txt 改了,要有人定期看
💡 小提醒
很多公司評估「自己做還是找人做」時只比開發費用。比較誠實的比法是:開發費用加上兩年的維護與法遵複查,再對照直接買資料或談授權的價格。 算完之後,不少專案會發現正門其實比較便宜——這也是為什麼第一道關卡要放在最前面。
回到開頭那句話:爬蟲是最後手段。三道關卡不是為了阻止你做,是為了讓你做的時候站在有利的位置:資料來源交代得出來、進去的方式乾淨、用途說得清楚、系統壞了有人知道。如果你的公司正在評估資料蒐集的需求,不確定該走正門還是該自己做,需要有人一起把資料來源、法遵風險與後續維護盤過一遍,瞻新資訊的團隊可以協助釐清。
FAQ
爬蟲程式是什麼?跟搜尋引擎的爬蟲一樣嗎?
爬蟲程式是自動打開網頁、抓取內容、整理成結構化資料的程式;搜尋引擎的爬蟲是同一種原理,差別只在誰在用、拿來做什麼。 搜尋引擎抓網頁是為了建索引讓人搜到,網站通常歡迎;企業自己寫的爬蟲抓的是特定資料,要不要歡迎就看對方的條款與意願。想了解網站方怎麼看待與因應爬蟲,站上另有一篇專講網路爬蟲對網站的影響與因應。
爬蟲程式怎麼寫?一定要學 Python 嗎?有哪些套件?
不一定要學。一次性的小量擷取,用點選式的瀏覽器插件或 SaaS 工具就夠;要變成例行流程才值得用 Python,常見套件是 requests(取網頁)加 BeautifulSoup(解析),動態載入的頁面用 Playwright 或 Selenium 控制瀏覽器,多來源大量抓取用 Scrapy 框架。但比語法更重要的是先過三道關卡。
不會寫程式可以做爬蟲嗎?
可以,市面上有不少點選式擷取工具,適合頁面單純、量小、一次性的需求。不會寫程式的風險不在技術,在法律:工具再方便,登入牆後面的資料、別人編排的資料庫、含個資的名單,一樣不能因為「工具抓得到」就拿來用。
用爬蟲程式抓公開資料合法嗎?
不能只看公不公開。在台灣,判斷的是怎麼進去(要不要登入或付費、有沒有違反條款)、拿多少怎麼拿(整批重製還是少量事實)、拿來做什麼(內部分析還是做成跟對方一樣的產品)。台灣已經有實際判決顯示:資料本身公開,但以會員身分違規、用程式整批重製別人編排好的資料庫、再拿去做競爭對手的產品,是會有刑事責任的。實際情形請洽法律專業人士。
robots.txt 沒有擋,就可以爬嗎?
不等於。依網路標準 RFC 9309,robots.txt「不是一種存取授權」,它是網站告訴爬蟲哪裡不歡迎的告示牌,不是門鎖。 沒擋不代表條款允許、也不代表資料可以拿去用;反過來擋了你硬闖,雖然不會單獨構成違法,但它會成為對方意願的證據。
爬下來的資料可以做成產品或拿去賣嗎?
要看抓的是什麼。純粹的事實(價格、庫存、時刻)本身不受著作權保護;文章、圖片、商品描述是表達,整批拿去用幾乎過不了合理使用;別人選擇編排過的資料庫是編輯著作,就算內容是公開的法規也一樣受保護。 拿去做跟對方相同的服務,還可能碰到公平交易法。這三種情況疊在一起,正是風險最高的組合。
政府網站的資料可以直接爬嗎?
先去政府資料開放平臺找。平臺由數位發展部維運、有 API 服務資料集專區,依政府資料開放授權條款第 1 版,資料可以重製、改作、商業利用,條件是要依規定標示原資料提供機關,沒標示視為從頭沒取得授權。有開放資料就不必爬;平臺上沒有的,再回到三道關卡逐一檢查,法規條文本身不受著作權保護,但別人編排過的法規資料庫是另一回事。
對方網站改版,爬蟲壞掉怎麼辦?
這是常態不是意外。爬蟲的水管接在別人家的水龍頭上,對方改版你就要修;正確做法是一開始就把監控與告警(筆數、空值比例)、欄位驗證、重試上限、定期法遵複查做進專案裡,而不是等報表錯了才發現。評估自己做還是找人做時,要把兩年的維護算進去,再跟直接買資料或談授權的價格比。
參考資料
- 違反著作權法等案件新聞稿(2025-06-24 宣判) — 司法院全球資訊網(繁體中文,台灣,2026-09-13 查證)
- 著作權法 — 全國法規資料庫(繁體中文,台灣,最新修正 111-06-15,2026-09-13 查證)
- 中華民國刑法 — 全國法規資料庫(繁體中文,台灣,最新修正 115-07-22,2026-09-13 查證)
- 個人資料保護法 — 全國法規資料庫(繁體中文,台灣,最新修正 114-11-11,2026-09-13 查證)
- RFC 9309: Robots Exclusion Protocol — IETF(英文,國際標準,2022-09,2026-09-13 查證)
- 政府資料開放授權條款-第1版 — 政府資料開放平臺/數位發展部(繁體中文,台灣,104-07-27 訂定,2026-09-13 查證)
- 爬蟲軟體法律風險全解析:著作權、個資、合約與競爭法的界線在哪裡? — 李明勳律師,2025-07-15(繁體中文,台灣,具名律師文章,2026-09-13 查證)
- LinkedIn v. hiQ: Landmark Data Scraping Suit Provides Guidance to Data Scrapers and Web Operators — Morgan Lewis,2022-12-22(英文,美國,律師事務所評論,2026-09-13 查證)
- 政府資料開放平臺 — 數位發展部(繁體中文,台灣,2026-09-13 查證)
ℹ️ 關於本文
本文引用的法規條文、判決資訊與技術標準,以查閱當日(2026 年 9 月 13 日)全國法規資料庫、司法院網站與 IETF 公開文件的版本為準;法規可能修正、案件可能因上訴而改變結果,實際請以最新條文、判決與主管機關公告為準。文中對爬蟲程式法律風險與技術路線的說明屬一般性實務經驗整理,不構成法律意見,也不保證任何做法必然合法或不會被主張權利;涉及著作權、個人資料保護與競爭法的具體判斷,請洽律師或法律專業人士確認。

關於作者|張安邦執行長
台灣大學醫學工程研究所背景,十年以上軟體開發經歷,領軍瞻新資訊有限公司(2010年成立),完成專案200+、涵蓋40~50+個產業。專長:網頁設計、APP開發、UI/UX設計、LINE Bot自動化、系統開發、資訊安全。

