作者|瞻新資訊 張安邦執行長(台大醫工背景・十年以上IT服務公司創辦人)
這幾年只要談到幫公司做 AI 客服、內部知識庫,或是「讓員工用問的就能找到手冊」,報價單上大概都會出現一行:向量資料庫。
很多人看到這個詞的第一個反應是:我們已經有資料庫了,怎麼又要一個?
這篇想先把一件事講清楚:向量資料庫跟你現在用的資料庫,不是同一種東西,也不是要拿來取代誰。它是幫既有資料做「找相似」這件事的一層。這一點搞懂了,「要不要另外買一套」「客戶資料放進去安不安全」「要多少資料量才需要」這幾個問題,答案會自己浮出來。
先講結論:向量資料庫是「找相似」的那一層,不是要換掉的資料庫
先給一個能直接記住的定義:向量資料庫(vector database)是用來儲存、索引、查詢「向量」的系統;向量就是把一段文字、一張圖片、一份文件,經由 AI 模型轉成的一串數字。 這串數字代表的是「意思」,兩份意思相近的文件,數字會靠得很近。
那「向量資料」又是什麼?就是這些轉好的數字本身。Google Cloud 的官方說明頁把向量嵌入(embedding)講成「資料的數值表示法」,並說「相似項目會彼此靠近,不相似的項目則會相距較遠」——這句話就是整個技術的核心。
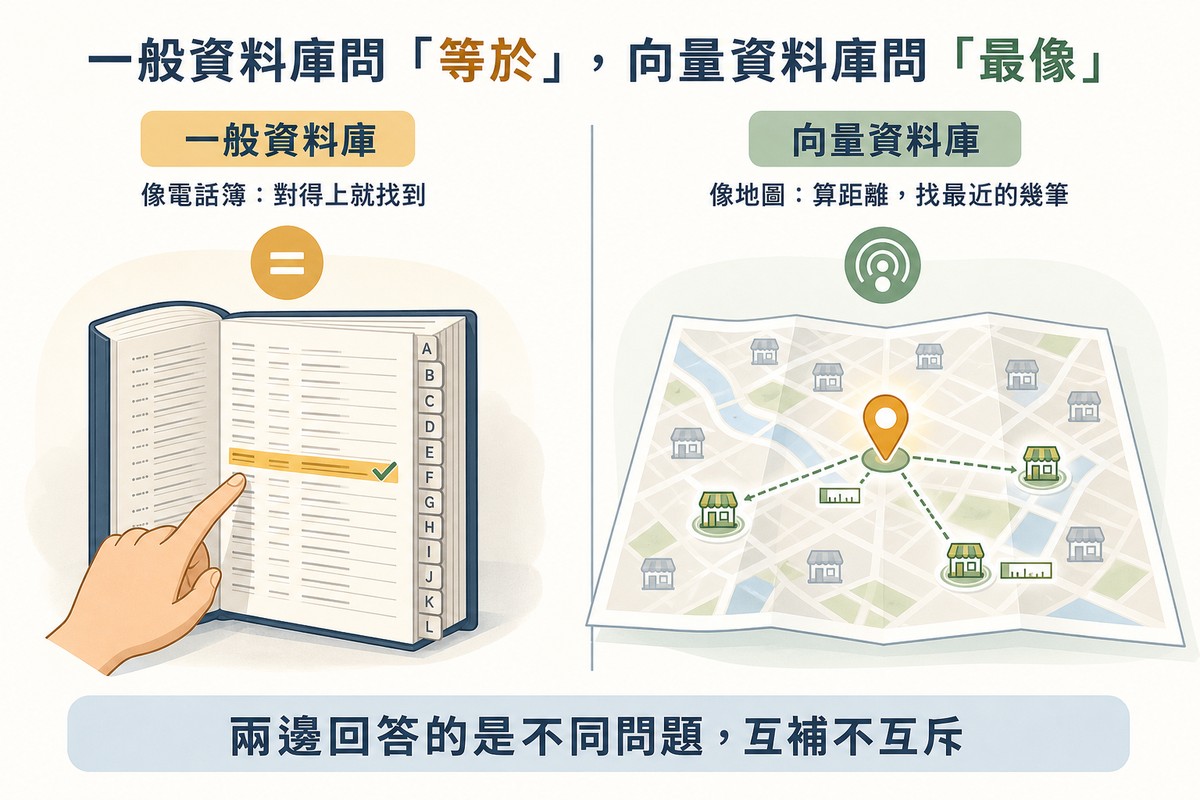
所以它回答的問題跟一般資料庫不一樣。一般資料庫回答「哪一筆等於、哪幾筆符合條件」;向量資料庫回答「哪幾筆最像」。
用一個生活裡的畫面來講。電話簿是照姓名筆畫排的,你要找「王小明」,翻到王就找到了,這是精確比對。地圖不一樣,地圖上每家店都有一個座標,你問「離我最近的三家咖啡店」,它算距離給你答案,這是找相似。向量就是每份文件在地圖上的座標;向量資料庫就是那張會幫你算距離的地圖。
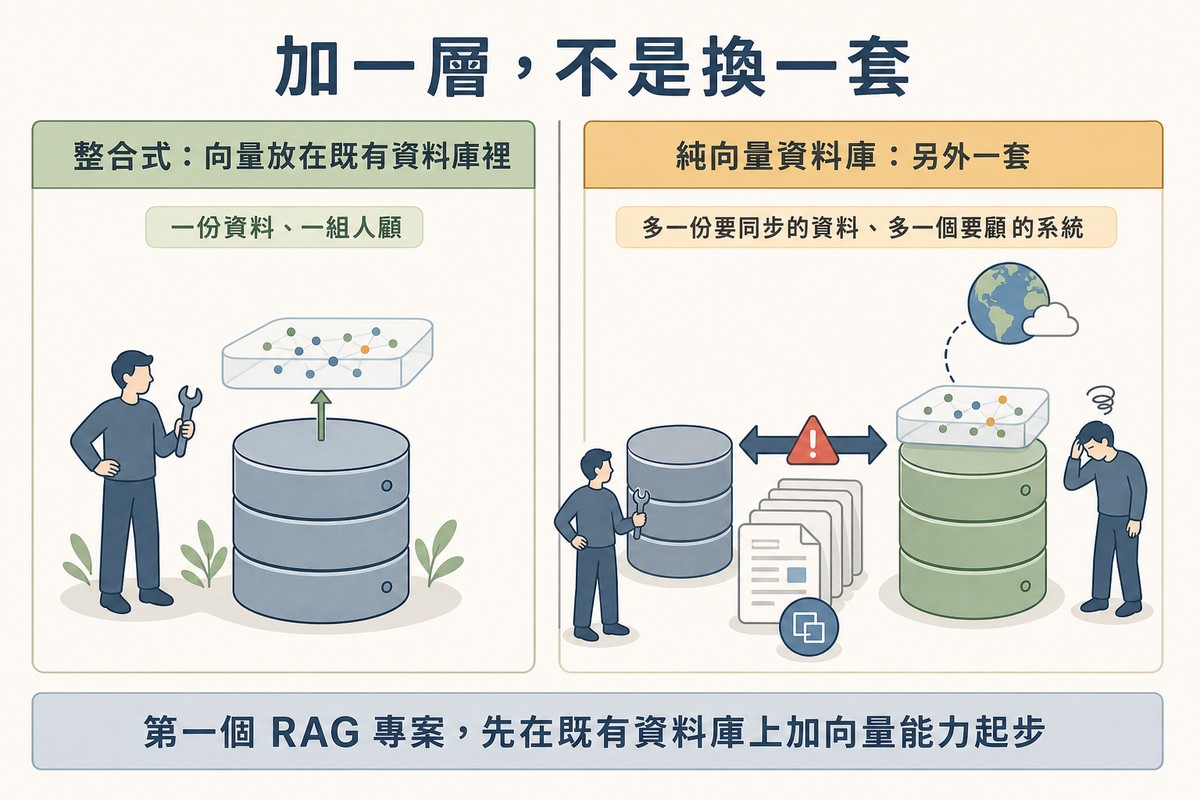
也因為這樣,它從來不是拿來取代電話簿的。客戶資料、訂單、庫存,該放在原本的資料庫還是放在那裡;向量資料庫是在旁邊多一層,專門負責「意思相近」這種查詢。多數專案是「加一層」,不是「換一套」。 這個觀念先立住,後面的判斷才不會歪。
一句話收尾:向量資料庫是找相似的索引層,跟你原本的資料庫是分工,不是替代。
它怎麼「找意思相近的」:向量、距離、精確與近似
原理其實不難,拆成三步。
第一步,轉成數字。 把每段文字送進一個叫 embedding(嵌入)的模型,模型會吐出一串數字,通常是幾百到上千個。你不用懂那些數字各代表什麼,只要知道:意思相近的兩段話,數字會很像;意思差很多的,數字會差很多。
第二步,算距離。 你問一個問題,問題本身也會被轉成一串數字。接著系統去比:資料庫裡哪幾筆的數字跟這串最接近。最接近的前幾筆,就是「意思最像」的答案。
第三步,加速。 資料只有幾千筆的時候,全部算一遍沒問題。到了幾百萬筆,每問一次都全部算一遍就太慢了,所以會建索引。這裡有一個很重要、但多數文章不會講白的取捨:
建索引之後,系統不再「全部翻一遍」,而是「先看分區、再翻最可能的幾區」,速度快很多,但有很小的機率漏掉真正最像的那一筆。
這不是我自己的講法,是 PostgreSQL 向量擴充 pgvector 的官方文件原話:預設做的是精確的最近鄰搜尋,召回率是百分之百;加了索引之後改用近似搜尋,用一點召回率換速度。它提供兩種索引:HNSW 的速度與召回率取捨比較好,但建索引慢、吃比較多記憶體;IVFFlat 建得快、記憶體少,查詢表現差一些。你不必記名字,只要知道「要快還是要準」是一個可以調的旋鈕,不是二選一。
對業主來說,這一段真正要記的只有一件事:「找相似」本來就是一種機率性的查詢,不像查訂單編號那樣非黑即白。 這會影響你之後怎麼看待「AI 答錯了」這件事。
一句話收尾:向量搜尋是算距離找最近的,加了索引就是用一點準確度換速度,這是設計上的取捨,不是故障。
跟你現在的資料庫差在哪,一張表講清楚
如果你對「資料庫到底是什麼、關聯式跟非關聯式差在哪」還不太熟,站上另一篇資料庫是什麼?從定義、種類到系統開發中的角色講得比較完整,這裡只比對跟向量資料庫的差別。
| 你現在的資料庫(關聯式/NoSQL) | 向量資料庫 | |
|---|---|---|
| 回答的問題 | 哪一筆等於?哪幾筆符合條件? | 哪幾筆最像? |
| 資料長什麼樣 | 欄位、表格、文件 | 一串代表意思的數字(向量)+少量標籤 |
| 怎麼比對 | 精確比對、範圍條件 | 算距離、依相似度排序 |
| 答案的性質 | 確定的集合 | 依相似度排序的前幾名,帶機率性 |
| 擅長 | 交易、帳務、庫存、會員 | 語意搜尋、找相似文件或圖片、推薦 |
| 不擅長 | 「意思相近」的模糊查詢 | 精確條件、交易一致性 |
看完表格會發現:兩邊擅長的事幾乎互補,這就是為什麼多數專案是「兩個一起用」而不是「選一個」。 訂單還是在原本的資料庫裡,只是多了一層可以用「意思」去找的能力。
順帶一提,這也是為什麼「向量資料庫」這個名字有點誤導。它更像一種索引與查詢能力,而不是一種要獨立採購的資料庫產品。 Google Cloud 自己的說明頁就寫得很白:這些功能「直接整合至代管服務,包括 AlloyDB for PostgreSQL、Spanner 和 BigQuery」,讓你「不必管理個別基礎架構」。這幾年主流資料庫幾乎都把向量搜尋做成內建功能了,下面會再講。
一句話收尾:兩種資料庫回答的是不同的問題,互補不互斥。
什麼情況會用到:RAG、語意搜尋、推薦
原理講再多,不如講你什麼時候會碰到它。
RAG(檢索增強生成)。 這是目前最常見的用途。你把公司的手冊、合約範本、客服紀錄丟進去,員工或客戶用問的,系統先「找相似」撈出最相關的幾段,再交給 AI 模型組成答案。向量資料庫在這裡的角色,就是「先找出該看哪幾頁」的那一步。 AWS 的技術指南把這個流程講成四步:文件送進 embedding 模型、轉成代表語意的向量、存進向量資料庫、應用程式查詢時做相似度搜尋。如果你打算接 ChatGPT 這類模型做客服,站上ChatGPT API 的導入說明講的是模型那一端;本篇只講「找資料」這一端。(RAG 本身是另一個題目,這篇不展開。)
語意搜尋。 官網的站內搜尋,客戶打「電腦一直發燙」,傳統關鍵字搜尋找不到「散熱異常排除」那篇,因為字面不同;向量搜尋找得到,因為意思相近。
推薦與找相似。 「看了這個商品的人也看了」「找跟這張圖風格接近的」,本質都是算距離。
中小企業實際會遇到的,九成是第一種。所以接下來的判斷,都以「你要做一個 RAG 型的知識庫或客服」為前提。
一句話收尾:中小企業碰到向量資料庫,多半是因為要做 RAG;它負責的是「先找出該看哪幾頁」。
第一個專案,先在既有資料庫上加一層就好
這是本篇最想講的判斷。
市面上的向量資料庫分兩種形態,微軟的技術文件把它們分得很清楚:一種是純向量資料庫,獨立存向量和少量標籤,跟原始資料分開放;另一種是整合式向量資料庫,向量功能直接內建在你已經在用的關聯式或 NoSQL 資料庫裡,向量跟原始資料放在一起。
微軟文件對整合式的說法很直接:向量跟原始資料放在一起,就不必為了複製資料到另一套純向量資料庫而多付成本,一致性、擴充性也比較好;原文還有一句「此方法可讓您無須將資料移轉至成本較高的替代向量資料庫」。AWS 列出來的向量資料庫選項,也幾乎全是既有服務加上向量能力:PostgreSQL 加 pgvector、OpenSearch、DocumentDB、MemoryDB。三家最大的雲端業者,講的是同一件事。
為什麼這件事對中小企業特別重要?算一筆帳就知道:
- 多一套系統,就多一份要同步的資料。手冊改了版,原本的資料庫更新了,向量那邊沒更新,AI 就會拿舊版回答。
- 多一套系統,就多一個要有人維運的東西:備份、更新、權限、監控。你原本的資料庫已經有人在顧了,向量擴充是順便顧;獨立系統是另外一份工。
- 多一套系統,多半就多一個資料放在別人機房的問題(下面個資那一節會講)。
那效能上,起步階段真的夠用嗎?Supabase 在 2023 年做過一次公開實測(這是供應商自己的測試,數字當參考、不是定論):用一台每月約 410 美元的主機,跑 100 萬筆 1536 維的 OpenAI 向量,在把準確度對齊到跟 Pinecone 的 s1 方案相同的 0.98 時,pgvector 的每秒查詢數多了 1185%,每月還便宜 70 美元。對多數中小企業的知識庫來說,資料量離 100 萬筆還很遠。
那到底多少筆算「撞牆」?我要誠實講:業界說法分歧,有人說 100 萬、有人說 1000 萬、也有實測跑到 5000 萬還撐得住,差別在硬體、維度、索引參數,和你能接受的延遲。所以這篇不給一個數字,給的是下一節的五個問題。
💡 小提醒
如果你的系統現在跑的是 PostgreSQL,加向量能力這件事,技術上是裝一個擴充套件、多一個欄位、建一個索引。它是一個「功能」,不是一個「採購案」。 先用這個做出第一版,驗證 RAG 對你的業務有沒有用,比先花錢買一套系統再來找用途,順序合理得多。至於原本的系統該留在現成方案還是客製,站上資料庫管理系統怎麼選那篇的判斷仍然適用。
一句話收尾:第一個 RAG 專案,先在既有資料庫上加向量能力起步;先驗證有沒有用,再談要不要換專用。
五個問題,判斷什麼時候該換專用的
「先用擴充」不代表永遠不用專用系統。專用向量資料庫存在是有理由的,只是該不該換,看的是你的狀況,不是產品的規格表。 這五個問題可以直接拿去問自己,也可以拿去問廠商。
| 問題 | 留在既有資料庫的擴充 | 該考慮專用系統 |
|---|---|---|
| ① 向量有幾筆、成長多快? | 幾萬到幾十萬筆,成長平緩 | 千萬等級且持續成長 |
| ② 資料多久更新一次? | 每天或每週批次更新 | 每分鐘都在寫入、要即時可查 |
| ③ 查詢要不要先過濾? | 條件單純(部門、日期) | 多租戶隔離、複雜權限、多欄位組合過濾 |
| ④ 資料可以放哪裡? | 含個資、要留在自己機房或台灣 | 資料本身不敏感、可接受託管 |
| ⑤ 誰來維運? | 現有人力已在顧這個資料庫 | 有人能專責顧新系統,或用託管服務 |
幾個補充。
第①題最常被高估。很多人會把「文件有幾萬份」直接當成向量筆數,但實際筆數是「切塊之後」的段落數,不是文件份數。 怎麼估?一份 50 頁的手冊,一頁通常切成大約十段,就是四、五百筆;一千份這樣的手冊,大約是四、五十萬筆。用這個方法估完,多數中小企業會發現自己落在左邊那一格。
第③題是專用系統真正的強項之一。AWS 文件列出選錯向量資料庫的後果,裡面就有「缺乏過濾與排序這類進階功能」。如果你的知識庫要做到「業務只能查到自己客戶的資料」,過濾能力要先確認。
第④、⑤題跟技術無關,跟公司有關。答案是「留在自己這邊」和「沒人能多顧一套」的話,專用系統再強都先不用考慮。
一句話收尾:五個問題裡只要有兩題以上落在右邊,才值得認真評估專用系統;否則先留在擴充。
客戶資料轉成向量之後,個資法一樣管
這一節中文文章幾乎沒人寫,但對台灣的中小企業很實際。
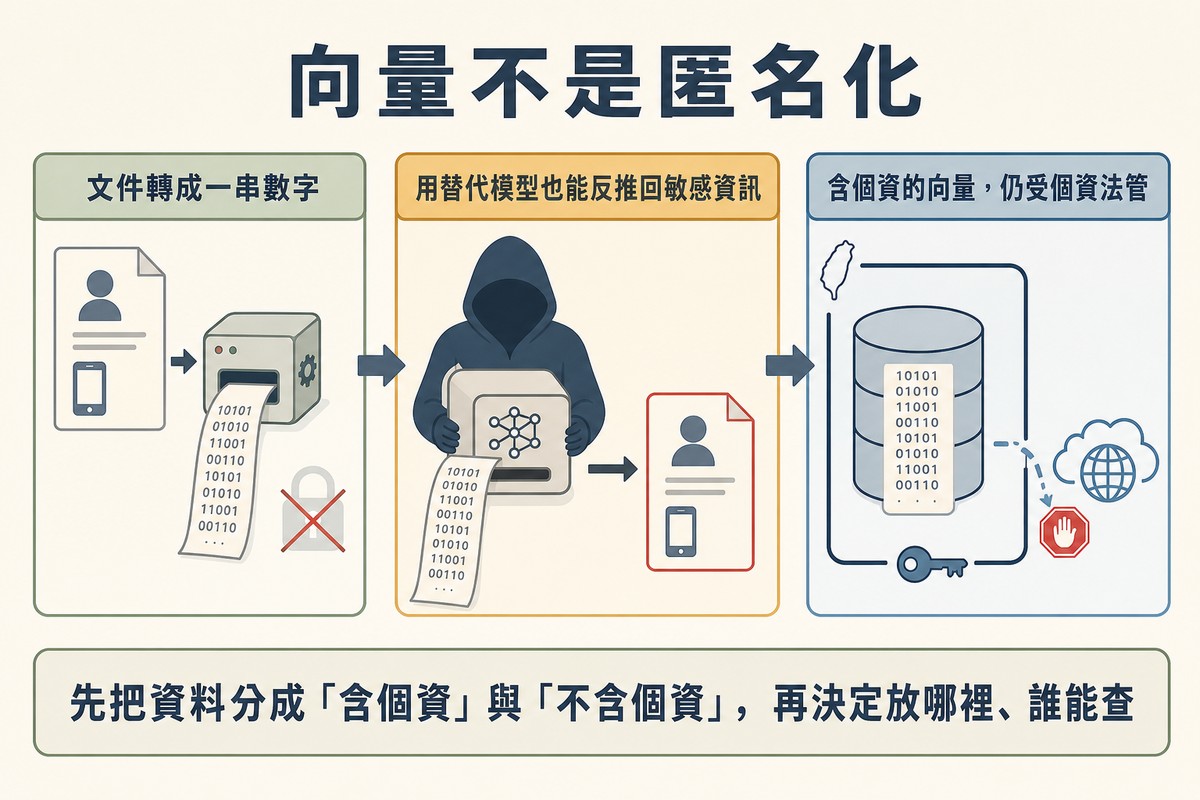
有一種直覺是:「文件轉成一串數字了,看不出原文,應該就不算個資了吧?」這個直覺是錯的。
台灣大學團隊在 2024 年發表於 ACL(自然語言處理領域的頂尖會議)的研究證明,攻擊者就算拿不到當初轉換用的 embedding 模型,用一個替代模型也能從文字向量反推出敏感資訊。換句話說,向量不是加密,也不是匿名化,它只是換了一種表示法。
這不只是學術上的提醒。OWASP 在 2025 年版的 LLM 應用十大風險裡,把向量與嵌入的弱點獨立列成一項(LLM08:2025),點名的情況包括:權限控管不足導致有人拿到含敏感資訊的向量、多個部門或客戶共用同一個向量資料庫時的交叉洩漏,以及前面講的反推攻擊。它給的防護建議也很具體:做到「知道權限」的向量儲存、資料進去前要驗證來源、檢索活動要留下不可竄改的紀錄。
再看法規。《個人資料保護法》第 2 條對「個人資料」的定義,看的是能不能「直接或間接識別該個人」,沒有規定要存成什麼格式才算。所以:
- 把含客戶姓名、電話、病歷的文件轉成向量,仍然是個資的處理,第 20-1 條要求的安全維護義務一樣適用。
- 把這些向量放到海外的託管服務,就是個資的國際傳輸;第 21 條規定在特定情形下主管機關得限制。
⚠️ 注意
這不是說不能用託管的向量資料庫,而是用之前要先做一件事:把資料分成「含個資」和「不含個資」兩類。產品手冊、公開的 FAQ、內部流程文件,放哪裡都相對單純;客服紀錄、合約、任何有客戶身分的內容,要先決定資料放在哪、誰能查、查了有沒有紀錄。實際適用範圍請以主管機關公告與最新條文為準。
這也是上一節第④題存在的理由。資料能不能出去,常常比效能更早決定你該用哪一種。 這個判斷邏輯跟站上談雲端預約系統資料主權那篇是同一套:先問資料在誰手上,再問功能。
一句話收尾:向量不是匿名化,含個資的內容轉成向量、放到海外,個資法照樣適用;進去之後誰能查,也要管到向量那一層。
型號、料號、法條號:純向量會漏,要混合檢索
再講一個上線之後才會發現的問題。
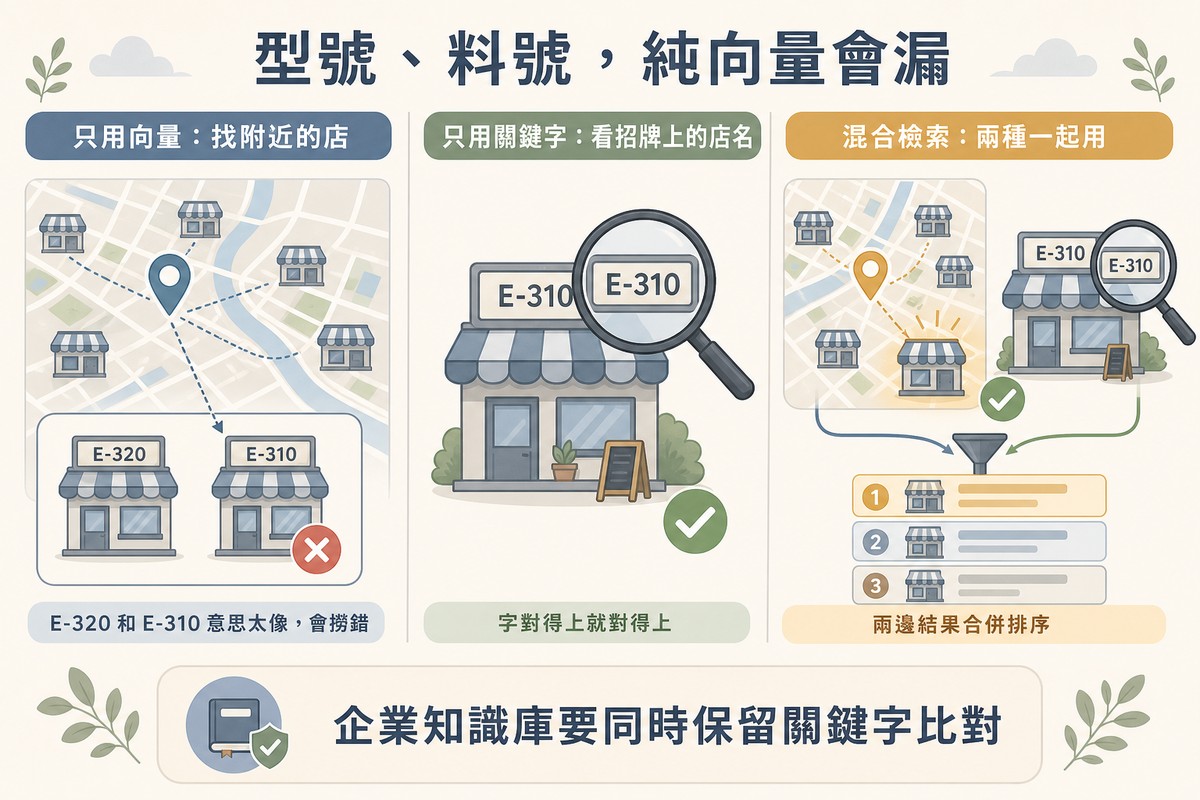
有些公司把十年的客服紀錄和產品手冊全部丟進 RAG,測試時問「機器一直發燙怎麼辦」,答得很好;正式上線後客服問「E-320 的保固期多久」,系統卻撈出 E-310 的資料。為什麼?
因為向量抓的是「意思」,而型號、料號、法條號這種東西,在意思上幾乎一模一樣。E-320 和 E-310 都是「某台機器的型號」,對模型來說語意幾乎相同,在向量空間裡靠得非常近,它分不太出來。這不是資料庫壞了,是這種查詢本來就不該只靠向量。反過來,傳統的關鍵字搜尋剛好擅長這件事:字串對得上就是對得上。
所以正規的做法叫混合檢索(hybrid search):同一個問題,同時用關鍵字找一次、用向量找一次,再把兩邊結果合併排序。 這不是什麼冷門技巧,pgvector 的官方文件就直接寫著,建議搭配 PostgreSQL 的全文檢索一起用。
回到地圖的比喻:向量搜尋是「找附近的店」,關鍵字搜尋是「看招牌上的店名」。 只用其中一種,都會有找不到的時候。
💡 小提醒
評估廠商或方案時,可以直接問一句:「型號和料號這種精確詞,你們的檢索怎麼處理?」答得出「混合檢索」或「關鍵字加向量」的,才是真的做過企業知識庫。
一句話收尾:企業知識庫的檢索要同時保留關鍵字比對,純向量會把型號搞混。
RAG 答不好,先別怪資料庫
最後講一個常見的誤判。系統上線後 AI 常答錯,第一個念頭往往是「是不是向量資料庫選錯了、要換一套」。多數時候,問題不在那一層。
實務上更常見的原因是:
- 切塊切壞了。 文件在轉向量之前會被切成一段一段,切的方式如果只看字數,一條「以下情形不適用保固:……」的條文可能被切成兩半,前半段在這一塊、條件在下一塊。AI 拿到的是不完整的條件,當然答錯。 就像把合約影本每頁撕成兩半再歸檔,找到了也看不懂。
- 新舊版本混放。 2020 年和 2024 年的退貨規定同時在資料庫裡,系統依相似度撈,兩份都很像,撈到哪一份看運氣。
- 沒有人負責更新。 導入時很認真,半年後手冊改版了沒人同步,AI 回答的永遠是導入那天的版本。
- embedding 模型不支援中文。 用了以英文為主訓練的模型處理中文內容,「意思相近」算得不準,再好的資料庫也救不回來。
這些問題有一個共同點:都發生在資料進資料庫「之前」,換資料庫不會改善。 反過來說,先把切塊、版本、更新機制、模型選擇處理好,用既有資料庫的向量擴充,多數中小企業的知識庫就能穩定運作。
至於「要不要換專用系統」,回到前面那五個問題就好;它是一個成長之後才需要面對的問題,不是起步時的問題。
我最常被問的其實不是「該用哪一套」,而是「我知道要做 AI 知識庫,但說不清楚要做什麼」。這種情況很正常,也正是該先釐清的:資料有哪些、含不含個資、放哪裡、誰維護,想清楚這幾件事,向量資料庫的選擇通常就只剩一兩個合理答案。 如果你的公司正在評估這類專案,需要有人幫忙把資料狀況、既有系統與整合方式一起盤過一遍,瞻新資訊的團隊可以協助釐清。
FAQ
向量資料庫是什麼?跟一般資料庫差在哪?
向量資料庫是用來儲存、索引、查詢「向量」的系統;向量是把文字、圖片等資料經由 AI 模型轉成的一串代表意思的數字。 它回答的是「哪幾筆最像」,一般資料庫回答的是「哪一筆等於、哪幾筆符合條件」。兩者擅長的事互補,實務上多半一起用:交易與帳務留在原本的資料庫,向量那一層負責語意搜尋與 RAG 檢索。
向量資料庫有哪些?
大致分兩類。專用(純向量)資料庫,例如 Pinecone、Milvus、Weaviate、Qdrant、Chroma;整合式,也就是既有資料庫內建的向量功能,例如 PostgreSQL 的 pgvector 擴充、Elasticsearch/OpenSearch 的向量搜尋,以及 Google Cloud、AWS、Microsoft 各自資料庫服務內建的向量能力。 對已經有資料庫的中小企業,先看自己的資料庫有沒有整合式選項,通常是比較省事的起點。
向量資料庫的原理是什麼?
三步:把資料經 embedding 模型轉成一串數字(向量)、把問題也轉成向量、比較兩者的距離找出最接近的幾筆。資料量大的時候會建索引(常見的是 HNSW),改用近似搜尋,速度快很多但用一點召回率交換,這是 pgvector 官方文件也明講的取捨。
如何建立向量資料庫?
順序是:決定要「找相似」的是哪批資料、選一個支援中文的 embedding 模型、決定文件怎麼切塊、決定放在既有資料庫的擴充還是專用系統、建索引、加上部門或日期等過濾條件、驗證命中率與延遲、最後訂好更新與下架機制。其中「切塊」和「更新機制」是最常被忽略、也最影響 RAG 品質的兩步。
我們用 PostgreSQL,一定要另外買向量資料庫嗎?
多數情況不用。對已經有 PostgreSQL 的中小企業,第一個 RAG 專案通常用 pgvector 這類擴充起步就夠,Google Cloud、微軟與 AWS 的技術文件都把「在既有資料庫內建向量功能」列為正式選項。等資料量、更新頻率、過濾需求或維運狀況真的撞到上面的五個問題,再評估專用系統。
資料量多大才需要專用的向量資料庫?
沒有公認的數字。業界說法從 100 萬到 5000 萬筆都有,差別在硬體、向量維度、索引參數和你能接受的延遲。 比較可靠的判斷不是筆數,而是五個問題:向量筆數與成長速度、更新頻率、過濾條件的複雜度、資料能不能放到外面、誰來維運;而且筆數要用切塊後的段落數估,不是文件份數。
把客戶資料放進海外的向量資料庫服務,安全嗎?
要先分清楚資料含不含個資。台灣大學團隊 2024 年的研究證明文字向量可以被反推出原本的敏感資訊,向量不是匿名化;含個資的內容轉成向量後仍受個資法規範,放到海外服務就是國際傳輸。產品手冊、公開 FAQ 這類不含個資的內容放託管服務相對單純;客服紀錄與合約要先決定資料放哪、誰能查、有沒有紀錄。實際適用請以主管機關公告與最新條文為準。
RAG 一定要用向量資料庫嗎?
不一定。文件只有幾十份、問題也很固定的話,用全文檢索甚至直接把文件放進提示就能跑;要做到「用意思找」、文件量又多,才需要向量那一層。 而且就算用了向量,企業知識庫也應該保留關鍵字比對做混合檢索,否則型號、料號這類精確詞會找錯。
參考資料
- 什麼是向量資料庫?運作方式為何? — Google Cloud(繁體中文,全球,2026-09-13 查證)
- LLM08:2025 Vector and Embedding Weaknesses — OWASP GenAI Security Project,2025(英文,國際安全組織,2026-09-13 查證)
- Overview of vector databases — AWS Prescriptive Guidance — Amazon Web Services(英文,全球,2026-09-13 查證)
- pgvector: Open-source vector similarity search for Postgres — pgvector 官方 README(英文,開源專案,2026-09-13 查證)
- 整合向量資料庫 – Azure Cosmos DB — Microsoft Learn(繁體中文,全球,2025-09-04 更新,2026-09-13 查證)
- Transferable Embedding Inversion Attack: Uncovering Privacy Risks in Text Embeddings without Model Queries — Huang, Tsai, Hsiao, Lin, Lin,ACL 2024(英文,台灣大學團隊,2026-09-13 查證)
- 個人資料保護法 — 全國法規資料庫(繁體中文,台灣,最新修正 114-11-11,2026-09-13 查證)
- pgvector vs Pinecone: cost and performance — Supabase Blog,2023-10-10(英文,供應商自測,2026-09-13 查證)
ℹ️ 關於本文
本文引用的技術文件、研究與法規內容,以查閱當日(2026 年 9 月 13 日)各官方網站與全國法規資料庫的版本為準;資料庫產品的功能、效能實測與法規條文都可能更新,實際請以各原廠最新文件與主管機關公告為準。文中對「要不要採用專用向量資料庫」的判斷屬一般性實務經驗說明,實際情形因資料量、系統架構與組織狀況而有明顯差異,不構成任何效能、成本或合規的保證;涉及個人資料處理與跨境傳輸的判斷,建議洽法律專業人士或主管機關確認。

關於作者|張安邦執行長
台灣大學醫學工程研究所背景,十年以上軟體開發經歷,領軍瞻新資訊有限公司(2010年成立),完成專案200+、涵蓋40~50+個產業。專長:網頁設計、APP開發、UI/UX設計、LINE Bot自動化、系統開發、資訊安全。

